


AI/LLM Firewall как техническая точка контроля корпоративного использования GenAI
Корпоративное использование генеративного искусственного интеллекта формирует новый канал передачи и обработки информации, который не всегда контролируется традиционными средствами информационной безопасности.
В работе рассматривается архитектура централизованного контроля обращений к внешним и внутренним языковым моделям на базе AI/LLM Firewall, реализуемого средствами LLM Proxy или AI Gateway. Предлагается архитектура, включающая идентификацию пользователей, корпоративных приложений и AI-агентов, анализ и классификацию запросов, псевдонимизацию, токенизацию и маскирование данных, безусловное блокирование секретов, маршрутизацию запросов между моделями различного уровня доверия, контроль ответов и централизованное журналирование.
Отдельное внимание уделено контролю AI-агентов и построению единого контура мониторинга с использованием средств Observability, SIEM, DLP, IAM/PAM, EDR/NDR и SOC. Представленный подход может использоваться как практическая архитектурная основа для организации безопасного корпоративного доступа к генеративному искусственному интеллекту.
Введение
Генеративные модели искусственного интеллекта за короткий период превратились из экспериментальной технологии в инструмент, непосредственно используемый в корпоративных бизнес-процессах.
Сотрудники применяют ИИ для анализа документов, формирования отчетности, написания программного кода, поиска ошибок, подготовки коммерческих предложений, обработки обращений клиентов и выполнения иных задач.
Одновременно с этим возникает принципиально новый канал движения корпоративной информации. При использовании внешнего сервиса генеративного искусственного интеллекта сотрудник фактически передает часть корпоративной информации за пределы контролируемой инфраструктуры организации. При этом содержание запроса может включать персональные данные, коммерческую тайну, техническую документацию, программный код, финансовые показатели, учетные данные или другую информацию ограниченного доступа.
Особенность проблемы заключается в том, что традиционная модель контроля доступа отвечает преимущественно на вопрос, имеет ли пользователь право получить определенную информацию. При использовании генеративного ИИ дополнительно необходимо определить, имеет ли он право передать эту информацию конкретной модели искусственного интеллекта и при каких условиях такая передача допустима.
Таким образом, возникает необходимость формирования централизованной технической точки контроля, через которую могут проходить корпоративные обращения пользователей, приложений и AI-агентов к внешним и внутренним моделям искусственного интеллекта. Такой точкой контроля может выступать AI/LLM Firewall, реализованный на базе LLM Proxy или AI Gateway.
В отличие от традиционного межсетевого экрана, AI/LLM Firewall должен принимать решение не только на основании сетевого источника и назначения обращения, но и с учетом содержания запроса, категории передаваемых данных, идентичности и полномочий субъекта, используемой модели, характера выполняемой операции и установленных политик информационной безопасности [1,2].
1. Задача централизованного контроля корпоративного ИИ
Необходимость централизованного контроля корпоративного использования генеративного ИИ обусловлена несколькими практическими проблемами.
1.1. Неконтролируемая передача информации
Наиболее очевидным является риск передачи во внешние ИИ-сервисы информации ограниченного доступа.
Сотрудник может передать такую информацию как осознанно, например для анализа документа, так и непреднамеренно — путем загрузки большого массива данных, содержащего отдельные конфиденциальные фрагменты.
1.2. Использование несанкционированных сервисов
При отсутствии корпоративного инструмента сотрудники начинают самостоятельно выбирать публичные сервисы генеративного ИИ.
В результате подразделение информационной безопасности не располагает полной информацией:
Какие модели используются.
Какие сведения им передаются.
Где физически выполняется обработка.
Сохраняется ли история запросов.
Используются ли данные для обучения модели.
Какие программные интерфейсы получают доступ к корпоративной информации.
1.3. Использование AI-агентов
Дополнительный уровень риска возникает при использовании автономных AI-агентов.
Если традиционный пользователь вручную формирует отдельный запрос, агент потенциально может самостоятельно обращаться к файловым системам, корпоративным базам данных, почте, системам разработки, API и внешним сервисам.
Таким образом, ошибка конфигурации или избыточные полномочия AI-агента могут привести к значительно большему объему неконтролируемого доступа к информации.
Для реализации такого контроля требуется промежуточный технический слой между корпоративными пользователями, приложениями и AI-агентами, с одной стороны, и внешними или внутренними моделями искусственного интеллекта — с другой.
2. AI/LLM Firewall как централизованная точка контроля
Параллельно развиваются специализированные технические решения класса AI Gateway. Современные платформы AI Gateway могут обеспечивать централизованное проксирование запросов к различным моделям, управление квотами, журналирование, применение политик безопасности и мониторинг обращений [4].
В отдельных AI Gateway реализуются DLP-функции, позволяющие анализировать как запрос пользователя, так и ответ модели, выявлять чувствительную информацию и выполнять блокирование запросов в соответствии с установленными политиками [5].
Вместе с тем в корпоративной инфраструктуре функции такого шлюза целесообразно рассматривать шире, чем обычное проксирование. В настоящей работе под AI/LLM Firewall понимается централизованная техническая точка применения политик информационной безопасности при взаимодействии пользователей, корпоративных приложений и AI-агентов с внешними и внутренними моделями искусственного интеллекта.
Технически AI/LLM Firewall может быть реализован посредством LLM Proxy или AI Gateway либо специализированного программного комплекса. Его функции должны охватывать полный цикл взаимодействия с моделью: идентификацию и авторизацию субъекта, анализ содержимого запроса, классификацию передаваемых данных, применение политик информационной безопасности, преобразование защищаемой информации, выбор допустимой модели, контроль ответа и журналирование результата.
В отличие от классического межсетевого экрана, объектом контроля AI/LLM Firewall является не только сетевое соединение. Решение должно учитывать содержимое запроса, категорию передаваемой информации, идентичность и полномочия пользователя или AI-агента, используемую модель, характер выполняемой операции и установленные политики информационной безопасности.
В зависимости от применяемой политики AI/LLM Firewall должен обеспечивать возможность разрешения запроса, псевдонимизации, токенизации или маскирования отдельных значений, маршрутизации запроса в модель соответствующего уровня доверия либо полного блокирования передачи.
В предлагаемой архитектуре AI/LLM Firewall реализуется как промежуточный слой между корпоративными пользователями, приложениями и AI-агентами, с одной стороны, и внешними или внутренними LLM — с другой. Все контролируемые обращения к моделям проходят через LLM Proxy или AI Gateway, где до передачи данных применяются установленные политики информационной безопасности.
Одной из ключевых задач AI/LLM Firewall является предотвращение неконтролируемой передачи корпоративной информации в LLM до выполнения анализа запроса и применения установленных политик информационной безопасности.
Упрощенно процесс обработки обращения пользователя, корпоративного приложения или AI-агента выглядит следующим образом:
LLM Proxy или AI Gateway.
Анализ и классификация данных.
Проверка политик ИБ.
Псевдонимизация, токенизация, маскирование или блокирование.
Передача запроса в разрешенную LLM.
Получение ответа от LLM.
Обратное восстановление токенизированных данных внутри корпоративного контура.
Контроль результата.
Возврат ответа инициатору обращения.
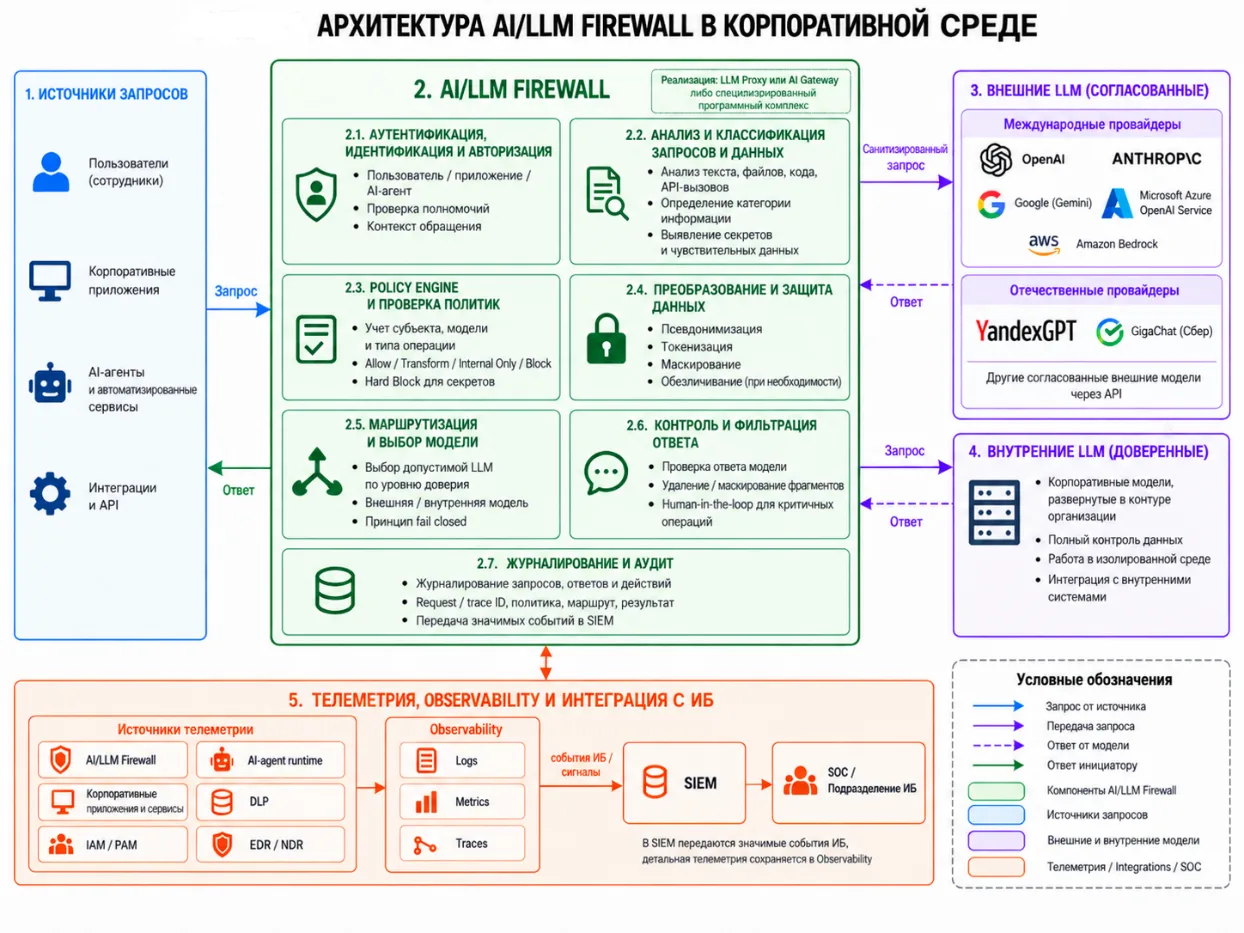
Рисунок 1 — Архитектура AI/LLM Firewall в корпоративной среде.
Перед отправкой запроса во внешнюю модель AI/LLM Firewall анализирует его содержимое и определяет наличие персональных данных, коммерческой тайны, учетных данных, исходного кода и другой защищаемой информации.
Если передача определенной категории данных допустима только после исключения исходных идентифицирующих значений, шлюз выполняет их псевдонимизацию, токенизацию либо маскирование.
Например, исходный запрос:
«Подготовь заключение по договору с Ивановым Иваном Ивановичем, паспорт 45 00 123456».
До передачи во внешнюю модель может быть преобразован в:
«Подготовь заключение по договору с [PERSON_001], паспорт [DOCUMENT_001]».
При этом таблица соответствия между исходными значениями и техническими идентификаторами сохраняется исключительно внутри доверенного корпоративного контура и не передается поставщику LLM.
После обработки внешняя модель может вернуть ответ вида:
«По договору с [PERSON_001] необходимо уточнить реквизиты [DOCUMENT_001]».
AI/LLM Firewall получает этот ответ и внутри корпоративной инфраструктуры выполняет обратную подстановку исходных значений:
«По договору с Ивановым Иваном Ивановичем необходимо уточнить реквизиты паспорта 45 00 123456».
Таким образом, внешняя модель обрабатывает токенизированные или маскированные данные, а пользователь получает результат уже с восстановленным контекстом.
При этом для отдельных категорий информации применение механизмов псевдонимизации, токенизации, маскирования или обезличивания не должно рассматриваться как достаточное основание для разрешения передачи. Например, пароли, токены доступа, закрытые ключи и иные секреты должны выявляться и блокироваться без передачи во внешнюю модель.
AI/LLM Firewall также может выполнять маршрутизацию запросов. В зависимости от категории данных запрос направляется:
Во внешнюю корпоративную LLM.
Во внешнюю LLM только после токенизации, псевдонимизации или маскирования.
Во внутреннюю LLM.
Либо полностью блокируется.
Таким образом, AI/LLM Firewall выступает централизованной точкой применения политик информационной безопасности при работе с искусственным интеллектом.
При использовании токенизации соответствие между исходными значениями и техническими идентификаторами сохраняется исключительно внутри доверенного корпоративного контура, что соответствует общему принципу минимизации рисков обработки и раскрытия чувствительной информации [7]. Внешняя LLM не получает исходные значения и не обладает информацией, необходимой для их восстановления. Обратная подстановка выполняется AI/LLM Firewall после получения результата от модели.
3. Политики обработки данных на уровне AI/LLM Firewall
Одной из ключевых функций AI/LLM Firewall является определение допустимого способа обработки информации до ее передачи в языковую модель. Для этого передаваемые данные должны классифицироваться в соответствии с корпоративной политикой информационной безопасности, а результат классификации использоваться Policy Engine для выбора последующего действия. В рамках предлагаемой архитектуры информацию целесообразно разделить на четыре класса.
3.1. Класс 1. Открытая информация
Информация, передача которой внешнему сервису не создает значимого риска.
Например:
Публичные материалы организации.
Опубликованные инструкции.
Общедоступные технические сведения.
Для данной категории может быть разрешено использование согласованных внешних моделей.
3.2. Класс 2. Внутренняя информация
Информация, предназначенная для внутреннего использования, но не относящаяся к критически значимой.
Передача такой информации во внешнюю модель может разрешаться только через AI/LLM Firewall с применением установленных политик контроля и обязательным журналированием операции.
3.3. Класс 3. Конфиденциальная информация
К данной категории могут относиться персональные данные, коммерческая тайна, внутренние финансовые сведения, договорные документы, сведения о клиентах и иная защищаемая информация.
В зависимости от установленной политики AI/LLM Firewall должен применять к такой информации одно из следующих действий:
Запрет использования внешней модели.
Псевдонимизация или токенизация отдельных значений.
Маскирование данных.
Обезличивание, если обратное восстановление исходных данных не требуется.
Маршрутизация запроса во внутреннюю или иную доверенную модель.
3.4. Класс 4. Критическая информация
К данной категории целесообразно относить сведения, обработка которых средствами LLM недопустима независимо от места размещения модели и возможности применения механизмов преобразования данных, например:
Пароли.
Токены доступа.
Закрытые криптографические ключи.
Секреты приложений.
Данные привилегированных учетных записей.
Отдельные категории критической технической информации.
При выявлении такой информации должно применяться правило Hard Block — запрос блокируется до передачи в LLM независимо от возможности применения псевдонимизации, токенизации или маскирования.
Таким образом, результат классификации должен непосредственно преобразовываться в техническое действие AI/LLM Firewall. В базовом варианте могут использоваться четыре типа политик:
Allow — передача разрешена.
Transform — передача разрешена после псевдонимизации, токенизации или маскирования.
Internal Only — обработка допускается только во внутренней или иной доверенной LLM.
Block — передача запрещена.
Указанные политики должны задаваться централизованно и применяться до фактической отправки данных поставщику модели.
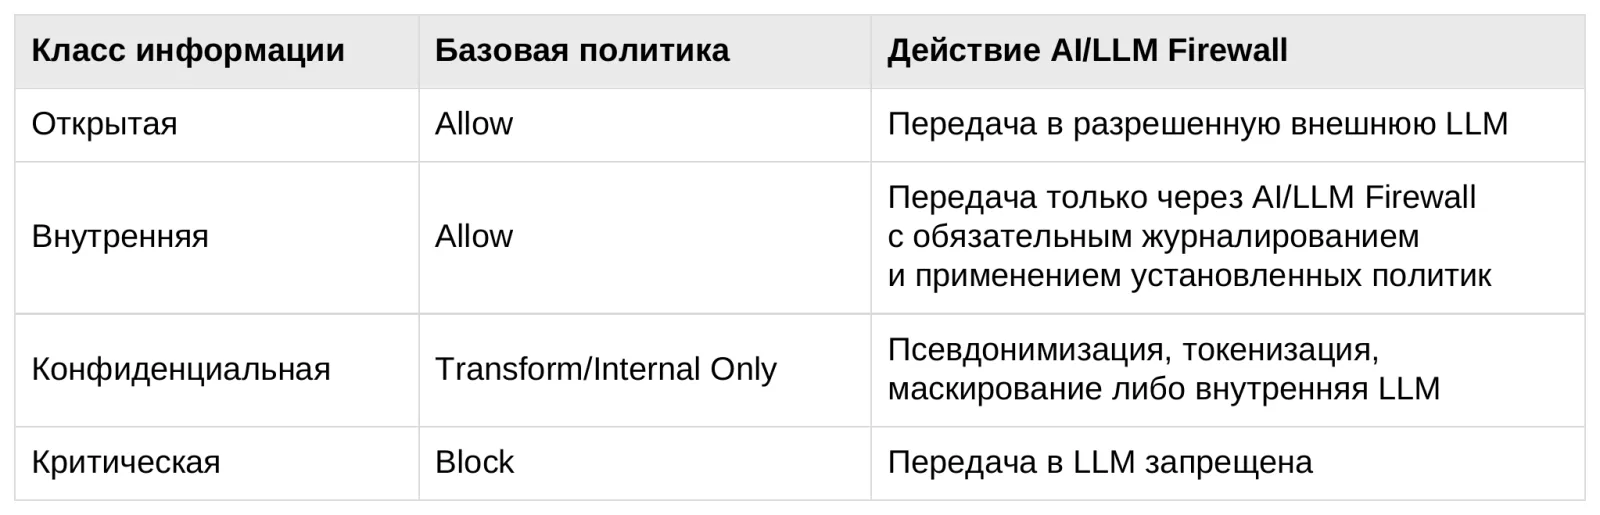
Таблица 1 — Базовые политики обработки информации средствами AI/LLM Firewall.
4. Функциональная архитектура AI/LLM Firewall
Практическая реализация AI/LLM Firewall должна включать набор взаимосвязанных функций, обеспечивающих контроль полного жизненного цикла обращения к языковой модели — от идентификации субъекта и анализа запроса до обработки ответа, журналирования и передачи событий в системы мониторинга.
LLM Proxy или AI Gateway в данной архитектуре выступает технической платформой реализации указанных функций и обеспечивает централизованное применение политик информационной безопасности к обращениям пользователей, корпоративных приложений и AI-агентов.
4.1. Аутентификация, идентификация и авторизация субъектов
Все обращения к моделям искусственного интеллекта должны выполняться от имени идентифицированного субъекта. В качестве субъекта могут выступать пользователь, корпоративное приложение, интеграционный сервис или AI-агент.
Для интерактивного доступа пользователей AI/LLM Firewall целесообразно интегрировать с корпоративной системой управления идентификацией и доступом (IAM/IdP) с использованием механизмов единого входа и, при необходимости, многофакторной аутентификации.
Корпоративные приложения и AI-агенты должны использовать отдельные сервисные учетные записи или иные технические идентификаторы. Использование общей сервисной учетной записи несколькими независимыми агентами или приложениями затрудняет аудит действий и должно быть ограничено.
После идентификации субъекта AI/LLM Firewall должен определять применимую политику доступа с учетом его роли, подразделения, уровня полномочий, типа обращения и разрешенных моделей. Это позволяет, например, предоставить разным группам пользователей доступ к различным LLM либо установить специальные ограничения для AI-агентов.
Анонимное использование корпоративного AI/LLM Firewall должно быть исключено. Для каждого обращения должна сохраняться возможность однозначно определить субъект, инициировавший запрос.
При передаче запроса между компонентами ИИ-инфраструктуры идентичность субъекта должна сохраняться в контексте обращения. Это необходимо для применения политик безопасности, ведения аудита и последующей корреляции событий в SIEM. При этом учетные данные пользователя, пароли и иные секреты не должны передаваться языковой модели как часть пользовательского запроса.
4.2. Анализ и классификация запросов и передаваемых данных
До передачи запроса в языковую модель AI/LLM Firewall должен выполнять анализ его содержимого и определять наличие защищаемой информации. Контроль должен распространяться не только на текст пользовательского запроса, но и на передаваемые документы, файлы, фрагменты программного кода, параметры API-вызовов, контекст, сформированный корпоративным приложением или AI-агентом, а также данные, получаемые из корпоративных источников и добавляемые к запросу.
В процессе анализа могут выявляться персональные данные, сведения, составляющие коммерческую тайну, финансовая и договорная информация, внутренние документы, исходный программный код, учетные данные, пароли, API-ключи, токены доступа, закрытые криптографические ключи и иные сведения ограниченного доступа.
Для выявления таких данных могут использоваться правила и словари, регулярные выражения, механизмы DLP, анализ структуры документов, а также контекстные и семантические методы классификации. Практическая реализация может использовать комбинацию нескольких механизмов, поскольку отдельный способ обнаружения не обеспечивает одинаковую точность для всех типов информации.
Дополнительно AI/LLM Firewall может выполнять анализ запросов на наличие признаков prompt injection, jailbreak и иных попыток обхода установленных ограничений. Такой контроль особенно важен в сценариях RAG и AI-агентов, где в контекст модели могут автоматически попадать данные из документов, внешних источников или результатов вызова инструментов. Полученный из таких источников контент не должен автоматически рассматриваться как доверенный и может проверяться до включения в контекст языковой модели [3].
По результатам анализа запросу должна присваиваться категория информации в соответствии с политиками, определенными в разделе 3. Одновременно могут фиксироваться обнаруженные типы защищаемых данных и необходимые ограничения на их дальнейшую обработку.
Результат классификации передается в Policy Engine AI/LLM Firewall, который определяет последующее техническое действие: разрешить передачу запроса, выполнить псевдонимизацию, токенизацию или маскирование, перенаправить запрос во внутреннюю или иную доверенную модель либо полностью заблокировать операцию.
При этом классификация должна выполняться до фактической передачи содержимого внешнему поставщику LLM, поскольку применение политик безопасности после отправки запроса не предотвращает раскрытие информации.
Например, если пользователь загружает в AI/LLM Firewall договор, содержащий ФИО, паспортные данные и коммерческие условия, система должна определить соответствующие категории информации до передачи документа модели. В зависимости от установленной политики персональные идентификаторы могут быть токенизированы, отдельные фрагменты маскированы, а сам запрос направлен только в модель допустимого уровня доверия.
4.3. Псевдонимизация, токенизация и маскирование данных
Если по результатам классификации для запроса выбрана политика Transform, AI/LLM Firewall должен выполнить преобразование защищаемой информации до ее передачи языковой модели. В зависимости от типа данных и сценария обработки могут применяться псевдонимизация, токенизация или маскирование.
Псевдонимизация предполагает преобразование исходных идентифицирующих данных таким образом, чтобы без использования дополнительной информации их нельзя было однозначно связать с конкретным субъектом. Дополнительная информация, необходимая для обратного сопоставления, должна храниться отдельно внутри доверенного корпоративного контура.
Одним из технических способов реализации такого подхода может выступать токенизация, при которой исходное значение заменяется техническим токеном, например [PERSON_001], [DOCUMENT_001] или [CLIENT_042]. Таблица соответствия между токеном и исходным значением должна храниться только внутри доверенного корпоративного контура и не передаваться поставщику LLM.
Маскирование применяется в случаях, когда для выполнения запроса достаточно скрыть часть исходного значения и его последующее полное восстановление не требуется. Например, номер документа или банковской карты может передаваться только в частично скрытом виде.
Выбор конкретного механизма должен определяться политикой обработки соответствующей категории данных. Если исходные значения необходимо восстановить после получения ответа от модели, целесообразно использовать псевдонимизацию или токенизацию. Если восстановление не требуется, может применяться маскирование либо обезличивание данных.
Хранилище соответствий между исходными значениями и токенами должно быть изолировано от внешних LLM и доступно только компонентам AI/LLM Firewall, выполняющим преобразование и обратное восстановление данных. Доступ к такому хранилищу должен контролироваться, а операции создания, использования и удаления соответствий — журналироваться.
После получения ответа от внешней LLM AI/LLM Firewall выполняет контроль результата и, при необходимости, обратное восстановление токенизированных или псевдонимизированных значений внутри корпоративной инфраструктуры. Во внешнюю модель передаются только преобразованные значения, тогда как восстановленный ответ формируется уже внутри доверенного контура.
При этом применение механизмов Transform не должно автоматически означать, что передача любых данных во внешнюю LLM становится допустимой. Для паролей, API-ключей, токенов доступа, закрытых криптографических ключей и иных секретов должны применяться отдельные правила безусловного блокирования.
4.4. Безусловное блокирование запрещенной информации (Hard Block)
Для отдельных категорий информации применение механизмов псевдонимизации, токенизации или маскирования не должно рассматриваться как достаточная мера защиты. Если корпоративной политикой установлено, что передача определенных данных в LLM недопустима, AI/LLM Firewall должен применять правило Hard Block.
Безусловному блокированию могут подлежать пароли, API-ключи, токены доступа, закрытые криптографические ключи, секреты приложений, данные привилегированных учетных записей и иные сведения, передача которых прямо запрещена корпоративной политикой информационной безопасности.
Проверка правил Hard Block должна выполняться до применения маршрутизации запроса и до его фактической передачи во внешнюю или внутреннюю модель. При срабатывании правила дальнейшая обработка запроса прекращается, а защищаемое значение не должно передаваться LLM даже в преобразованном виде.
Инициатору обращения должна возвращаться информация о невозможности выполнения операции в соответствии с установленной политикой безопасности. При этом сообщение не должно повторно содержать обнаруженный секрет или иные критичные данные.
Факт блокирования должен журналироваться с указанием идентификатора субъекта, времени события, типа обнаруженной информации, примененного правила и результата обработки. Сами обнаруженные секреты не должны сохраняться в журнале в открытом виде.
События Hard Block, представляющие интерес с точки зрения информационной безопасности, могут передаваться в SIEM для последующей корреляции. Например, многократные попытки передачи токенов доступа или закрытых ключей одним пользователем, приложением или AI-агентом могут рассматриваться как признак ошибочной интеграции, нарушения установленной политики либо потенциально аномального поведения.
4.5. Маршрутизация запросов и выбор допустимоймодели
После применения политик классификации и защиты данных AI/LLM Firewall должен определить допустимый маршрут дальнейшей обработки запроса. Маршрутизация должна выполняться централизованно и исключать возможность самостоятельного выбора пользователем, корпоративным приложением или AI-агентом модели, не разрешенной корпоративной политикой.
Выбор маршрута может определяться категорией информации, результатом применения политики обработки, идентичностью и полномочиями субъекта, типом операции, а также установленным уровнем доверия к доступным моделям.
В базовом варианте логика маршрутизации может быть связана с политиками, определенными в разделе 3:
Allow — запрос передается в разрешенную внешнюю или внутреннюю LLM.
Transform — перед передачей во внешнюю LLM выполняется псевдонимизация, токенизация или маскирование защищаемых данных.
Internal Only — запрос направляется только во внутреннюю или иную доверенную модель.
Block — дальнейшая обработка прекращается, запрос не передается LLM.
Для одного сценария может быть разрешено несколько моделей. В этом случае AI/LLM Firewall может выбирать конкретную LLM с учетом доступности сервиса, установленных квот, стоимости обработки, требований к производительности и иных эксплуатационных параметров, при условии соблюдения заданного уровня доверия и политики информационной безопасности.
Если модель, соответствующая требованиям безопасности, недоступна, запрос не должен автоматически перенаправляться в менее доверенную среду. Для таких случаев целесообразно использовать принцип fail closed, при котором обработка прекращается либо запрос переводится на заранее определенный безопасный маршрут.
Все решения о маршрутизации должны журналироваться с указанием выбранной модели, примененной политики и причины выбора соответствующего маршрута. Это необходимо для последующего аудита и анализа событий информационной безопасности.
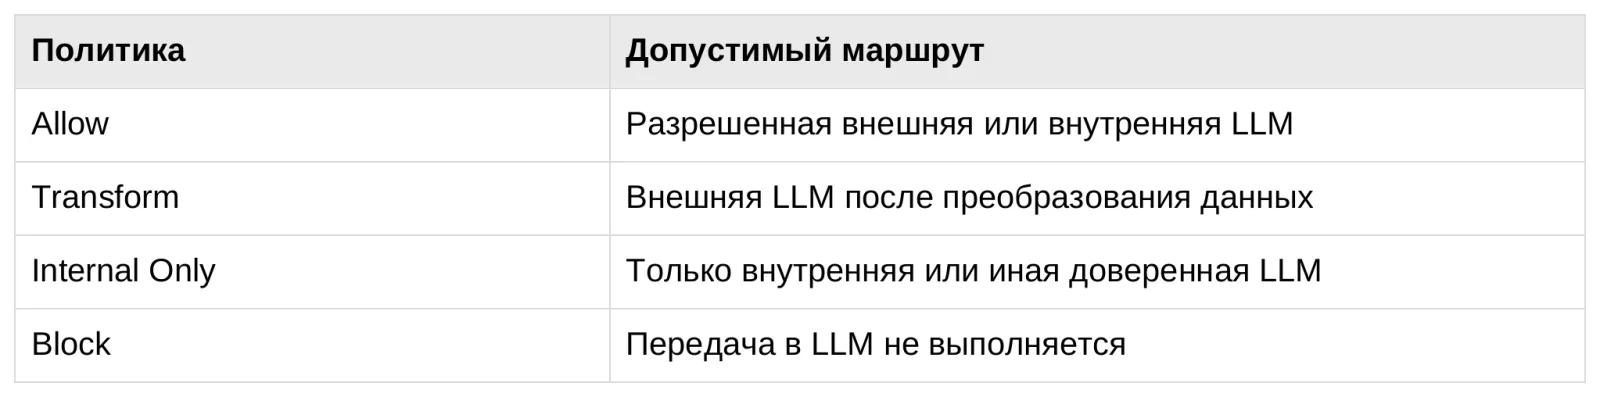
Таблица 2 — Соответствие политик допустимым маршрутам обработки.
4.6. Контроль обращений AI-агентов на уровне AI/LLM Firewall
AI-агенты должны рассматриваться AI/LLM Firewall как отдельный тип субъекта, для которого применяются специализированные политики доступа и обработки запросов.
Для каждого AI-агента необходимо использовать отдельный технический идентификатор либо отдельную сервисную учетную запись. Это позволяет однозначно определить источник обращения и применить соответствующий набор политик.
В агентных сценариях, если обращения к инструментам и API проходят через AI/LLM Firewall либо интегрированный с ним компонент контроля, для AI-агента целесообразно ограничивать:
Перечень разрешенных моделей.
Доступные API и инструменты.
Допустимые категории передаваемой информации.
Максимальный объем данных в одном запросе.
Частоту и количество обращений.
Допустимые типы операций.
Перечень корпоративных информационных систем, с которыми агент может взаимодействовать.
Для вызовов, способных привести к изменению данных, конфигурации информационных систем, отправке информации внешнему получателю или иным значимым последствиям, политика AI/LLM Firewall должна предусматривать возможность дополнительного подтверждения операции уполномоченным пользователем (Human-in-the-loop).
Обращения AI-агентов должны журналироваться отдельно от обычных пользовательских запросов с сохранением идентификатора агента, вызываемого инструмента или API, используемой модели, примененной политики и результата выполнения операции.
При выявлении нарушения установленной политики AI/LLM Firewall должен иметь возможность заблокировать отдельный запрос либо дальнейшие обращения конкретного AI-агента в соответствии с установленными правилами безопасности.
4.7. Контроль и фильтрация ответов языковой модели
Контроль AI/LLM Firewall должен распространяться не только на запросы, передаваемые языковой модели, но и на формируемые ею ответы. Ответ LLM не должен автоматически возвращаться пользователю, приложению или AI-агенту без применения установленных политик безопасности.
На этапе обработки ответа могут выполняться проверки на наличие защищаемой информации, учетных данных и секретов, запрещенного содержимого, небезопасных фрагментов программного кода, а также иных данных, передача которых конкретному субъекту не допускается установленной политикой.
Отдельное значение такой контроль имеет для AI-агентов и корпоративных приложений, поскольку результат работы модели может использоваться не только как информационный ответ, но и как входные данные для последующего вызова API, выполнения команды либо изменения состояния корпоративной системы.
В зависимости от результата проверки AI/LLM Firewall должен иметь возможность:
Разрешить возврат ответа без изменений.
Удалить или замаскировать отдельные фрагменты.
Заблокировать выдачу ответа.
Направить результат на дополнительную проверку.
Потребовать подтверждение уполномоченного пользователя для критичных операций.
Если при формировании запроса применялась токенизация или псевдонимизация, обратное восстановление исходных значений должно выполняться только внутри доверенного корпоративного контура. Целесообразно предусматривать контроль как ответа, полученного непосредственно от LLM, так и итогового результата после обратного восстановления данных перед его передачей конечному получателю.
Для сценариев, в которых ответ LLM содержит программный код, команды, параметры вызова внешних инструментов или инструкции для AI-агента, результат не должен автоматически рассматриваться как доверенный. Такие данные должны проходить дополнительные проверки в соответствии с характером последующей операции.
Факт блокирования или изменения ответа должен журналироваться с указанием примененной политики и результата обработки. События, представляющие интерес с точки зрения информационной безопасности, должны быть доступны для последующей передачи в SIEM и анализа подразделением ИБ или SOC.
4.8. Журналирование и аудит действий
AI/LLM Firewall должен обеспечивать централизованное журналирование всех значимых операций, выполняемых при обработке запросов к языковым моделям. Журналирование необходимо как для аудита использования корпоративного ИИ, так и для последующего анализа событий информационной безопасности.
Для каждого обращения целесообразно фиксировать:
Идентификатор пользователя, приложения или AI-агента.
Дату и время обращения.
Идентификатор запроса или сессии.
Используемую модель.
Результат классификации информации.
Примененную политику обработки.
Факт применения псевдонимизации, токенизации или маскирования.
Факт срабатывания Hard Block.
Выбранный маршрут обработки.
Результат контроля ответа.
Факт блокирования или изменения ответа.
Результат выполнения операции.
Для AI-агентов дополнительно целесообразно фиксировать идентификатор агента, вызываемый инструмент или API, тип выполняемой операции и результат ее выполнения.
Для обеспечения сквозного анализа событий все компоненты обработки одного обращения должны использовать единый идентификатор запроса или иной корреляционный идентификатор. Это позволяет связать между собой действия пользователя, корпоративного приложения или AI-агента, работу AI/LLM Firewall, обращение к модели и последующие операции.
Само журналирование не должно приводить к созданию дополнительного канала утечки информации. Полное содержимое запросов, ответов, обнаруженных секретов и исходных значений токенизированных данных не должно сохраняться в журналах без обоснованной необходимости. В большинстве сценариев достаточно фиксировать метаданные, категорию информации, идентификатор примененного правила и результат его выполнения.
Доступ к журналам должен быть разграничен, а сроки их хранения определяться корпоративной политикой и требованиями к расследованию инцидентов. Необходимо также обеспечивать защиту журналов от несанкционированного изменения или удаления.
События, имеющие значение для информационной безопасности, должны формироваться в структурированном виде и быть доступны для передачи в SIEM. Детальный порядок использования данных AI/LLM Firewall совместно с телеметрией Observability и другими источниками рассматривается далее в разделе мониторинга и реагирования.
4.9. Централизованное управление политиками AI/LLM Firewall
Управление политиками AI/LLM Firewall должно осуществляться централизованно через единый механизм принятия решений — Policy Engine. Его задача состоит в применении формализованных правил информационной безопасности к каждому обращению пользователя, приложения или AI-агента.
Политика должна учитывать не один признак, а совокупность параметров: идентичность и роль субъекта, категорию информации, используемую модель, тип выполняемой операции, источник запроса, применяемый сценарий и иные атрибуты, необходимые для принятия решения.
На основании этих параметров Policy Engine должен определять допустимое техническое действие — Allow, Transform, Internal Only или Block, а также дополнительные ограничения, включая выбор разрешенной модели, необходимость маскирования или токенизации, применение Hard Block и требование дополнительного подтверждения операции.
Централизованное управление политиками позволяет изменять требования безопасности без внесения изменений в каждое корпоративное приложение, использующее LLM. Приложение передает запрос в AI/LLM Firewall, а решение о допустимом способе обработки принимается на уровне единой политики.
Изменения политик должны выполняться контролируемо. Для каждой версии целесообразно фиксировать инициатора изменения, дату, содержание корректировки и основание для ее применения. Новые или существенно измененные правила рекомендуется предварительно проверять в тестовом режиме до их применения в продуктивной среде.
Необходимо предусматривать возможность быстрого отката к предыдущей версии политики при возникновении ошибок, а также сохранение истории изменений для последующего аудита и расследования инцидентов.
Права на изменение политик должны быть ограничены уполномоченными сотрудниками. При этом функции администрирования AI/LLM Firewall и утверждения правил информационной безопасности целесообразно разграничивать в соответствии с принятой в организации моделью распределения ответственности.
Таким образом, Policy Engine становится центральным механизмом, связывающим идентификацию субъекта, классификацию информации, преобразование данных, Hard Block, маршрутизацию запросов и контроль ответов в единый процесс применения политик информационной безопасности.
5. Уровни доверия к языковым моделям и средам обработки
Уровень доверия к языковой модели должен использоваться AI/LLM Firewall как один из параметров маршрутизации запросов. При этом оцениваться должна не только сама модель, но и среда ее эксплуатации, условия обработки данных и степень технического контроля со стороны организации.
В практической архитектуре целесообразно выделять три базовых уровня.
Публичные и несанкционированные модели — внешние сервисы, использование которых не согласовано организацией и не регулируется корпоративными договорными или техническими требованиями. Для таких сервисов организация, как правило, не контролирует условия хранения запросов, использование передаваемой информации, сроки ее удаления и механизмы журналирования. Обработка корпоративной информации в подобных сервисах должна быть запрещена либо существенно ограничена установленными политиками.
Корпоративные внешние модели — облачные или внешние LLM-сервисы, официально согласованные организацией и используемые на основании установленных договорных и технических условий. Для них могут быть определены требования к хранению данных, использованию запросов и ответов для обучения, срокам удаления информации, журналированию, аутентификации и допустимым категориям передаваемых данных.
Внутренние или иные доверенные модели — LLM, функционирующие в инфраструктуре организации либо в специально выделенной контролируемой среде. При этом сам факт размещения модели внутри корпоративного контура не должен автоматически означать высокий уровень доверия: должны также учитываться разграничение доступа, защита инфраструктуры, журналирование, используемые источники данных и возможность контроля действий модели и связанных с ней компонентов.
Уровень доверия к модели и среде ее эксплуатации целесообразно определять с учетом следующих факторов:
Места обработки и хранения данных.
Условий использования передаваемой информации поставщиком.
Возможности использования запросов и ответов для обучения модели.
Сроков хранения и возможности удаления переданных данных.
Применяемой юрисдикции.
Договорных обязательств поставщика.
Механизмов аутентификации и разграничения доступа.
Наличия технических механизмов контроля со стороны организации.
Возможности централизованного журналирования и аудита обращений.
Присвоенный уровень доверия должен фиксироваться в реестре разрешенных моделей и использоваться Policy Engine AI/LLM Firewall при выборе допустимого маршрута обработки. Например, политика Internal Only должна разрешать передачу запроса только в модели, которым заранее присвоен соответствующий уровень доверия.
Уровень доверия необходимо периодически пересматривать при изменении условий использования сервиса, договорных обязательств поставщика, архитектуры интеграции, механизмов хранения данных либо иных значимых параметров.
6. Безопасность AI-агентов как самостоятельных субъектов доступа
Использование AI-агентов требует отдельной модели безопасности, поскольку агент способен не только формировать запросы к LLM, но и самостоятельно обращаться к корпоративным информационным системам, API, файловым хранилищам и другим инструментам [8].
AI-агент должен рассматриваться как самостоятельный субъект доступа. Для него необходимо применять принцип минимальных привилегий и предоставлять только те полномочия, которые требуются для выполнения конкретного сценария.
Для каждого AI-агента должны быть определены:
Отдельная сервисная учетная запись или иной технический идентификатор.
Минимально необходимые права доступа.
Перечень разрешенных корпоративных информационных систем.
Перечень доступных API и инструментов (tool allow-list).
Допустимые типы операций.
Ограничения частоты и объема обращений.
Правила журналирования действий.
Механизм аварийного отключения (kill switch).
Не следует предоставлять AI-агенту доступ ко всем корпоративным ресурсам «от имени пользователя» только на основании того, что соответствующие права имеются у инициировавшего его работу сотрудника. Полномочия агента должны определяться отдельно и ограничиваться конкретным бизнес-сценарием.
Для доступа к корпоративным системам предпочтительно использовать отдельные сервисные учетные записи и, где это технически возможно, краткоживущие токены доступа. Передача AI-агенту долговременных пользовательских учетных данных, паролей, API-ключей и иных постоянных секретов должна быть исключена либо максимально ограничена.
Особое внимание необходимо уделять операциям, изменяющим состояние корпоративных систем. Для удаления или изменения данных, изменения конфигурации, выполнения финансово значимых операций, отправки информации внешним получателям и иных действий с существенными последствиями целесообразно применять механизм Human-in-the-loop, предусматривающий подтверждение операции уполномоченным сотрудником до ее фактического выполнения.
Вызовы инструментов и API должны журналироваться отдельно от обычных LLM-запросов. Для каждого действия целесообразно фиксировать идентификатор агента, вызываемый инструмент, целевую систему, тип операции, время выполнения и результат.
Контроль AI-агента должен охватывать не только отдельные действия, но и их последовательность. Средства Observability могут использоваться для анализа цепочек вызовов инструментов и API, объема обрабатываемых данных, частоты обращений, длительности выполнения сценариев, количества повторных попыток и возникающих ошибок.
Например, нетипичная последовательность «получение доступа к большому числу документов, массовое чтение данных, увеличение объема запросов, обращение к внешней LLM» может рассматриваться как единый подозрительный сценарий, а не как набор независимых технических событий.
События, представляющие интерес с точки зрения информационной безопасности, должны передаваться в SIEM для последующей корреляции с данными AI/LLM Firewall, IAM/PAM, DLP, EDR/NDR и других источников.
7. Observability, SIEM и SOC в архитектуре мониторинга корпоративного ИИ
Контроль корпоративного использования генеративного ИИ должен быть интегрирован в существующий контур мониторинга информационной безопасности организации. При этом источником телеметрии должен выступать не только AI/LLM Firewall, реализованный средствами LLM Proxy или AI Gateway, но и другие компоненты, участвующие в обработке запросов и выполнении действий AI-агентами.
К таким источникам могут относиться корпоративные приложения и интеграционные сервисы, API Gateway, среды исполнения AI-агентов, RAG-компоненты и векторные базы данных, IAM/PAM, DLP, EDR/NDR, а также специализированные платформы Observability.
Средства Observability позволяют централизованно собирать и анализировать журналы, метрики и трассировки (Logs, Metrics, Traces), формируемые компонентами ИИ-инфраструктуры. Такая телеметрия дополняет события, формируемые непосредственно средствами контроля LLM, и позволяет анализировать не отдельное обращение, а полный технологический путь его выполнения.
В корпоративную SIEM целесообразно передавать события, имеющие значение с точки зрения информационной безопасности, в том числе попытки передачи паролей, токенов и иных секретов, массовую обработку документов, передачу значительных объемов персональных данных, обращения к запрещенным моделям, многочисленные блокировки запросов, нарушения политик AI-агентами и иные признаки аномальной активности.
При этом весь массив технической телеметрии необязательно передавать непосредственно в SIEM. Подробные журналы, метрики и трассировки могут храниться и анализироваться в специализированной Observability-платформе, а в SIEM передаваться события и признаки, представляющие интерес для информационной безопасности.
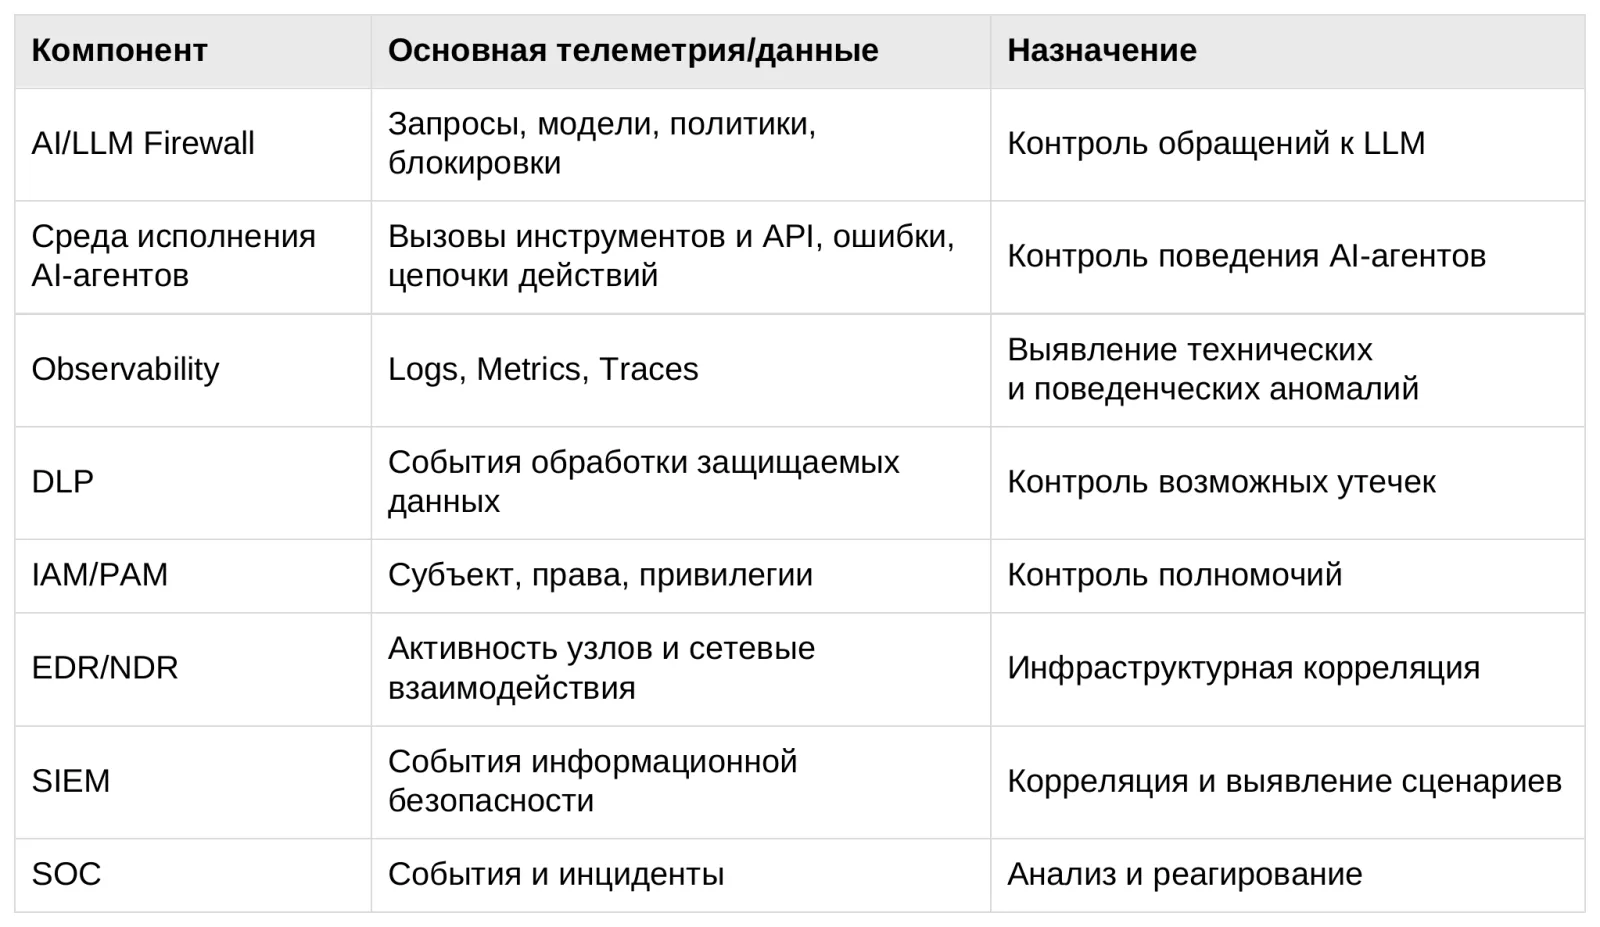
Таблица 3 — Компоненты мониторинга и назначение телеметрии.
SOC получает возможность коррелировать события AI/LLM Firewall с телеметрией AI-агентов, корпоративных приложений, средств Observability, DLP, IAM/PAM, EDR/NDR и других источников. Такой подход позволяет выявлять сложные сценарии, которые невозможно обнаружить по одному источнику данных.
Например, последовательность «аномальный рост активности AI-агента, массовое обращение к корпоративному хранилищу, увеличение объема обрабатываемых данных, попытка передачи информации во внешнюю LLM» может рассматриваться как единый подозрительный сценарий и инициировать дополнительный анализ либо расследование SOC.
События, классифицированные установленными политиками ИБ как значимые или критичные, должны передаваться на последующую обработку подразделению информационной безопасности или SOC и, при наличии соответствующих признаков, формировать инцидент информационной безопасности.
Таким образом, мониторинг использования генеративного ИИ должен охватывать не только непосредственные обращения к LLM, но и всю технологическую цепочку обработки запроса и выполнения связанных с ним действий.
8. Организационные меры и эксплуатация AI/LLM Firewall
Техническая реализация AI/LLM Firewall сама по себе не обеспечивает безопасное использование генеративного искусственного интеллекта. Для эксплуатации такого контура должны быть определены организационные процессы, распределение ответственности и порядок изменения установленных политик [6].
В организации целесообразно определить владельца корпоративной ИИ-платформы или соответствующей инфраструктуры, а также владельца политик информационной безопасности AI/LLM Firewall. Первый отвечает за техническую эксплуатацию и доступность решения, второй — за требования к допустимым моделям, категориям данных, правилам маршрутизации, блокирования и другим механизмам контроля.
Должны быть формализованы как минимум следующие процессы:
Подключение новой внешней или внутренней языковой модели.
Согласование нового сценария использования генеративного ИИ.
Регистрация и ввод в эксплуатацию нового AI-агента.
Изменение категорий информации и правил их обработки.
Изменение политик Allow, Transform, Internal Only и Block.
Пересмотр уровня доверия к используемым моделям.
Обработка ложных срабатываний и ошибочных блокировок.
Расследование событий и инцидентов информационной безопасности.
Аварийное ограничение или отключение отдельной модели, AI-агента либо сценария использования.
Подключение новой модели не должно ограничиваться техническим добавлением API-интерфейса модели в AI/LLM Firewall. До ее использования необходимо определить допустимые категории информации, условия хранения и обработки запросов, возможность использования данных поставщиком для обучения, требования к журналированию, применяемую юрисдикцию и другие параметры, влияющие на присвоенный модели уровень доверия.
Аналогичный подход должен применяться при подключении AI-агента. До ввода агента в эксплуатацию необходимо определить его владельца, бизнес-сценарий, сервисную учетную запись, допустимые информационные системы, перечень разрешенных API и инструментов, набор полномочий, ограничения частоты обращений и операции, требующие Human-in-the-loop.
Отдельный процесс должен быть предусмотрен для изменения политик AI/LLM Firewall. Существенные изменения целесообразно предварительно проверять в тестовом режиме, а после их ввода контролировать количество блокировок, ложных срабатываний и влияние на работу пользователей и корпоративных приложений.
Для спорных случаев должен существовать процесс обработки исключений. При этом исключение не должно реализовываться путем полного отключения контроля для пользователя или приложения. Оно должно быть ограничено конкретным сценарием, иметь владельца, срок действия и документированное основание.
Необходимо также предусмотреть процедуру экстренного реагирования, позволяющую оперативно заблокировать использование скомпрометированной модели, отключить AI-агента, отозвать технические учетные данные, изменить маршрут обработки либо временно перевести отдельный сценарий в режим Block или InternalOnly.
Перечень разрешенных моделей, AI-сервисов и AI-агентов должен поддерживаться в актуальном состоянии. Периодически необходимо пересматривать их уровень доверия, используемые интеграции, предоставленные полномочия и соответствие фактического использования установленным корпоративным политикам.
При этом полный запрет генеративного искусственного интеллекта не решает задачу контроля и может способствовать возникновению теневого использования публичных ИИ-сервисов. Поэтому организационные меры должны быть направлены не только на ограничение технологии, но и на создание контролируемого корпоративного способа ее применения.
9. Практический порядок внедрения AI/LLM Firewall
Внедрение AI/LLM Firewall целесообразно выполнять поэтапно, начиная не с выбора конкретного программного продукта, а с определения фактических сценариев использования генеративного искусственного интеллекта, категорий обрабатываемой информации и требуемого уровня контроля.
Практический порядок внедрения может включать следующие этапы:
Инвентаризация использования ИИ. Необходимо определить используемые сотрудниками и корпоративными приложениями ИИ-сервисы, подключенные языковые модели, существующие API-интеграции, AI-агентов и категории передаваемой информации. Отдельно целесообразно выявить несанкционированное использование публичных ИИ-сервисов.
Формирование контролируемого канала доступа. Корпоративные обращения к внешним и внутренним LLM должны переводиться через AI/LLM Firewall, реализованный посредством LLM Proxy или AI Gateway либо специализированного программного комплекса. Прямой неконтролируемый доступ к неразрешенным моделям по возможности должен быть ограничен.
Интеграция с корпоративной системой идентификации. Пользовательские обращения должны быть связаны с корпоративной учетной записью, а приложения и AI-агенты — с отдельными техническими идентификаторами или сервисными учетными записями. Это создает основу для применения различных политик в зависимости от субъекта обращения.
Настройка классификации данных и политик обработки. Для используемых категорий информации должны быть определены правила Allow, Transform, Internal Only и Block. Отдельно формируются правила Hard Block для паролей, API-ключей, токенов доступа, закрытых ключей и иных секретов.
Формирование реестра разрешенных моделей и правил маршрутизации. Для каждой модели необходимо определить уровень доверия, допустимые категории данных и условия использования. На основании этих параметров настраиваются маршруты обработки запросов, включая безопасное поведение при недоступности требуемой модели по принципу fail closed.
Интеграция с существующими средствами информационной безопасности и мониторинга. Должна быть обеспечена передача релевантных событий AI/LLM Firewall в SIEM и возможность их корреляции с данными IAM/PAM, DLP, EDR/NDR и Observability. При этом детальная техническая телеметрия может сохраняться в Observability-платформе, а в SIEM передаваться события, представляющие интерес с точки зрения информационной безопасности.
Пилотная эксплуатация. На первом этапе целесообразно ограничить использование выбранной группой пользователей, приложений и AI-агентов. В ходе пилота необходимо оценивать корректность классификации, количество ложных блокировок и пропусков, влияние политик на пользовательские сценарии, задержки обработки запросов и работоспособность механизмов маршрутизации.
Переход к промышленной эксплуатации. После стабилизации политик решение может распространяться на дополнительные подразделения и сценарии. Должны быть организованы постоянный мониторинг, обработка событий подразделением ИБ или SOC, управление изменениями, подключение новых моделей и AI-агентов, периодический пересмотр политик и процедуры аварийного ограничения доступа.
Эффективность внедренного контура может оцениваться не только количеством заблокированных запросов, но и долей корпоративных обращений к LLM, проходящих через контролируемый канал, количеством выявленных попыток передачи секретов, уровнем ложных срабатываний, числом обращений к неразрешенным моделям и полнотой журналирования действий пользователей, приложений и AI-агентов.
Поэтапное внедрение позволяет сначала сформировать базовый контролируемый канал доступа к генеративному ИИ, а затем последовательно расширять его за счет более сложных механизмов классификации, контроля AI-агентов, Observability и автоматизированного реагирования.
Заключение
Корпоративное использование генеративного искусственного интеллекта требует создания отдельного технического контура контроля взаимодействия пользователей, приложений и AI-агентов с внешними и внутренними языковыми моделями.
В качестве такой точки контроля может использоваться AI/LLM Firewall, реализуемый посредством LLM Proxy или AI Gateway либо специализированного программного комплекса. Его функции не должны ограничиваться проксированием запросов. Практическая архитектура должна включать идентификацию и авторизацию субъектов, анализ и классификацию передаваемой информации, применение политик обработки данных, псевдонимизацию, токенизацию и маскирование, безусловное блокирование секретов, маршрутизацию между моделями различного уровня доверия, контроль ответов и централизованное журналирование.
Отдельного контроля требует использование AI-агентов, поскольку они способны самостоятельно обращаться к корпоративным информационным системам, API и другим инструментам. Для них необходимо применять принцип минимальных привилегий, отдельные технические идентификаторы, ограничения доступных инструментов и операций, Human-in-the-loop для значимых действий, а также механизмы журналирования и аварийного отключения.
Контроль корпоративного ИИ не должен ограничиваться только AI/LLM Firewall. Для анализа полной технологической цепочки необходимо использовать телеметрию AI-агентов, корпоративных приложений, API-интеграций, RAG-компонентов и других элементов ИИ-инфраструктуры. Средства Observability могут обеспечивать сбор Logs, Metrics и Traces, а события, представляющие интерес с точки зрения информационной безопасности, должны передаваться в SIEM для последующей корреляции и обработки подразделением ИБ или SOC.
Практическое внедрение такого подхода целесообразно выполнять поэтапно: от инвентаризации существующих ИИ-сервисов и формирования контролируемого канала доступа до промышленной эксплуатации, централизованного управления политиками, мониторинга, подключения новых моделей и AI-агентов и периодического пересмотра установленных требований.
Предлагаемая архитектура позволяет перейти от неконтролируемого использования отдельных ИИ-сервисов к управляемому корпоративному контуру, в котором передача данных, выбор языковой модели, действия AI-агентов и события безопасности контролируются на основе единых технических и организационных политик.
Список литературы
Tabassi E. Artificial Intelligence Risk Management Framework (AI RMF 1.0). NIST AI 100-1. National Institute of Standards and Technology, 2023. DOI: 10.6028/NIST.AI.100-1.
Autio C., Schwartz R., Dunietz J., Jain S., Stanley M., Tabassi E., Hall P., Roberts K. Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile. NIST AI 600-1. National Institute of Standards and Technology, 2024. DOI: 10.6028/NIST.AI.600-1.
OWASP GenAI Security Project. OWASP Top 10 for LLM Applications 2026. OWASP Foundation, 2026.
Microsoft. AI gateway capabilities in Azure API Management. Microsoft Learn.
Cloudflare. AI Gateway: Data Loss Prevention, Guardrails and Logging. CloudflareDevelopersDocumentation.
ISO/IEC 42001:2023. Information technology — Artificial intelligence — Management system. International Organization for Standardization, 2023.
National Institute of Standards and Technology. NIST Privacy Framework: A Tool for Improving Privacy Through Enterprise Risk Management. Version 1.0. NIST, 2020. DOI: 10.6028/NIST.CSWP.10.
OWASP GenAI Security Project. OWASP Top 10 for LLM Applications 2025. OWASP Foundation, 2025.
Сведения об авторе
Назимкин Александр Евгеньевич — директор информационной безопасности ТПХ «Русклимат».
Российский исследователь и ИТ-эксперт в области информационной безопасности, систем автоматизированного проектирования (САПР) и охраны интеллектуальной собственности. Имеет многолетний научно-практический опыт работы в Федеральном институте промышленной собственности (ФГБУ ФИПС/Роспатент).
Активно сотрудничает с ведущими научно-образовательными центрами страны. Является постоянным участником и докладчиком на международных научно-практических конференциях факультета государственного управления МГУ имени М.В. Ломоносова, Московского государственного технического университета имени Н. Э. Баумана (МГТУ им. Н. Э. Баумана) и Института государственной службы и управления (ИГСУ РАНХиГС) при Президенте РФ. Научные работы автора также публиковались в изданиях НИЯУ МИФИ.
Имеет практический опыт руководства подразделениями информационной безопасности, построения и развития СУИБ, организации комплексной защиты корпоративной инфраструктуры и управления рисками информационной безопасности.
Сфера научных интересов: информационная безопасность и управление рисками; применение искусственного интеллекта в корпоративных информационных системах; автоматизация патентного поиска и экспертизы; поисковое проектирование сложных технических систем, включая БПЛА и малые космические аппараты; защита и сопровождение объектов промышленной собственности в сетях Интернет/Интранет; интерактивный синтез семантических моделей; проектирование радиационно-стойких электронных средств; энергосберегающие ИТ-технологии в государственном и муниципальном управлении.