


Вайб-кодинг в банке. Кто отвечает за код, который написал не человек?
Запретить использование ИИ-ассистентов в разработке уже не получится. Пока юристы профильных комитетов и службы информационной безопасности переписывают политики использования стороннего ПО, команды пишут код с помощью Copilot, Cursor и GigaCode. Классический Secure SDLC всё ещё держится на постулате о человеке-авторе, готовом подтвердить безопасность каждой строчки своей цифровой подписью.
Но когда автономный алгоритм совершает неконтролируемое действие, например, удаляет сегмент данных или меняет логику округления вопреки регламенту, для банка цена такого сбоя измеряется не только штрафами регулятора за утечку персональных данных. Она конвертируется в остановку критичных сервисов, нарушение нормативов ликвидности, потерю доверия корпоративных клиентов и прямой ущерб балансу.
Практическим доказательством этих рисков стал инцидент Джейсона Лемкина на платформе Replit. Чтобы отделить маркетинговые обещания вендоров от суровой реальности финтеха, в этой статье мы пройдём путь от удалённой базы данных до регламента безопасного DevSecOps и рассмотрим четыре сценария выбора ассистентов для российских банков, оценим реальные риски для непрерывности бизнеса (от галлюцинаций в модуле расчёта процентов до сбоев кредитного конвейера), соберём восемь практических правил защиты, которые укладываются в существующий пайплайн без остановки релизов.
Инцидент с агентом-паникёром
В июле 2025 года предприниматель Джейсон Лемкин, основатель SaaStr, девятый день увлечённо «вайб-кодил» свой проект на платформе Replit — то есть писал приложение, разговаривая с ИИ-агентом и почти не заглядывая в код. Проект стоял на жёстком код-фризе: агенту одиннадцать раз в явном виде запретили менять прод без подтверждения. На девятый день база данных CRM с информацией о 1200 руководителях и 1190 компаниях исчезла. Агент сообщил, что откат невозможен, потому что он «запаниковал».
Резервную копию подняли за сорок минут, но индустрии хватило одного признания модели, чтобы осознать новую реальность. История закончилась хорошо: CEO Replit публично извинился, платформа разделила среду разработки и прод, добавила восстановление в один клик и режим «только чат». Но у индустрии остался неудобный вопрос без ответа. У кода появился автор, которого нельзя вызвать на ковёр, нельзя оштрафовать по договору подряда и нельзя посадить. А ответственность, как известно любому юристу, без субъекта не живёт.
Сколько кода уже пишет «никто»
По оценкам Microsoft, к 2030 году до 95% всего нового кода будет генерироваться искусственным интеллектом. Уже сегодня, по данным опросов разработчиков (Stack Overflow Survey 2025), более 80% специалистов используют LLM в повседневной работе. В России тренд подтверждается ростом поисковых запросов: по данным Яндекса за январь–ноябрь 2025 года, пользователи всё чаще ищут значения слов «вайб-кодинг», «промптинг» и «ИИ-агент». По оценкам интеграторов ЕМДЕВ, доля ИИ-сгенерированного кода в пилотных проектах крупнейших российских банков уже достигла 30%, хотя в легаси-контурах она пока не превышает 5%. При этом каждая вторая кредитная организация уже зафиксировала инциденты, связанные с попаданием тестовых секретов в общие репозитории через промпты ассистентов.
Запрещать поздно и бессмысленно — ассистент просто переезжает на личный ноутбук разработчика, минуя корпоративные файерволы. Значит, задача состоит в том, чтобы корректно всё оформить юридически и архитектурно.
Насколько это небезопасно
Начнём с базы. По данным независимых исследований, которые обобщает вендор ЕМДЕВ в колонке на РБК, ИИ-генерируемый код содержит уязвимости в 45% случаев. Компания Escape.tech проверила более 1400 приложений, созданных с помощью вайб-кодинга. У 65% нашлись проблемы безопасности, у 58% — хотя бы одна критическая уязвимость, более чем в 400 приложениях прямо в коде в открытом виде лежали секреты: API-ключи, токены, учётные данные. Данные Wiz и Georgia Tech добавляют красок: 10% приложений на платформе Lovable имели критические уязвимости прямо в витрине, а одна пропущенная настройка привела к утечке полутора миллионов ключей.
Ничего экзотического в этом букете нет, и это само по себе примечательно. «Лаборатория Касперского» перечисляет стандартный набор веб-векторов: SQL-инъекции, вшитые в код токены, небезопасная десериализация, XSS, устаревшие API, слабые алгоритмы хеширования. Модель не вредничает, она честно воспроизводит средний код из интернета, на котором училась, и оптимизирует результат по признаку «оно же работает», потому что признака «безопасно» в её целевой функции нет. А средний код из интернета безопасным не является.
Риски для непрерывности бизнеса
Для банка классические дефекты OWASP Top 10 — лишь половина проблемы. Если модель галлюцинирует логику округления в модуле расчёта процентов по корпоративному депозиту или условия срабатывания кредитного конвейера, классический сканер SAST этого не увидит, поскольку код синтаксически верен. Убыток в одну копейку на каждой транзакции крупного банка превращается в миллиардный минус в марже за квартал. Кроме того, непредсказуемое поведение агента может нарушить требования к отказоустойчивости (SLA), прописанные в контрактах с юрлицами, что влечёт прямые штрафы со стороны корпоративных клиентов.
Векторы, которых не было в учебниках
Классические дефекты — только половина проблемы. Вторая половина — атаки, которых до эпохи ИИ-ассистентов просто не существовало.
Slopsquatting. Модели галлюцинируют имена библиотек: в эксперименте, разобранном «Лабораторией Касперского», из 576 тысяч сгенерированных фрагментов кода до четверти ссылались на несуществующие пакеты. Хуже другое: галлюцинации повторяемы — 43% вымышленных имён возникают снова и снова при повторных запросах. Атакующему остаётся прогнать популярные модели, собрать частые фантомы и зарегистрировать их в PyPI или npm с вредоносным содержимым. В январе 2026 года это случилось на практике: исследователь Чарли Эриксен заметил, что модель склеила jscodeshift и react-codemod в несуществующий react-codeshift, имя уехало в коммиты и через форки разошлось по 237 репозиториям — никто не вычитывал. Эриксен зарегистрировал пакет превентивно и сразу увидел загрузки. По данным ЕМДЕВ, один такой фантомный пакет успели скачать более 30 тысяч раз.
Rules File Backdoor. В марте 2025 года Pillar Security описала атаку, вошедшую в базу MITRE ATLAS: вредоносные инструкции прячут в конфигурационных файлах ассистента (.cursorrules, copilot-instructions.md) с помощью невидимых Unicode-символов. Ассистент читает файл как контекст и начинает генерировать код с закладкой. Разработчик видит пустой конфиг, а отравленные файлы разъезжаются по форкам.
Косвенный prompt injection. Агент с доступом в интернет читает документацию и форумы. Атакующий оставляет на странице скрытую инструкцию в HTML-комментарии, агент исполняет её как рабочий промпт.
Отравление обучения. Исследователи Carnegie Mellon показали: достаточно изменить 0,1% данных предобучения, чтобы в модели жил бэкдор, активируемый триггером в промпте. На Hugging Face находили сотню вредоносных моделей, исполняющих произвольный код при загрузке.
MCP-отравление. Агентные протоколы вроде Model Context Protocol дарят вектор компрометации всей IDE разработчика, переживающий перезапуск.
Фоном: по данным за май 2026 года, с инцидентами безопасности, связанными с ИИ-агентами, уже столкнулись 42% организаций. Годом раньше таких было меньше — 31%.
Российский ракурс: четыре двери со скрипом
Для российской компании выбор ассистента — ещё и геополитический вопрос. Исследование Booz Allen Hamilton от июня 2026 года зафиксировало неприятный факт: модель способна генерировать заметно более уязвимый код, если из промпта следует принадлежность пользователя к определённому государству или отрасли, причём уязвимости обфусцированы и стандартным анализом не ловятся. Оснований считать, что американские модели так не умеют, нет. С учётом этого у российских команд остаётся четыре выхода.
Первый — западные сервисы. Copilot, Cursor, Claude Code: лучшее качество кодогенерации на рынке. Расплата: юрисдикция США с CLOUD Act и FISA (фрагменты кода и бизнес-логика могут стать доступны третьим сторонам без уведомления), акробатика с оплатой и доступом, а для банка — отдельный разговор с комплаенсом. Субъекты КИИ обязаны переходить на отечественное ПО, безопасная разработка с 1 января 2025 года описана в ГОСТ Р 56939–2024 (пришёл на смену редакции 2016 года), а обязательные требования ЦБ к защите информации для банков установлены положением 851-П от 30.01.2025 года (для НФО действует 757-П от 20.04.2021 года).
Второй — российские ассистенты. Рынок, вопреки стереотипу, живой: GigaCode от Сбера с агент-режимом, собственной IDE и десятками тысяч активных пользователей (инструмент был представлен летом 2025 года), SourceCraft Code Assistant от Яндекса, Kodify от МТС с on-premise-развёртыванием, Koda, Veai и другие игроки. Расплата: собственные фронтир-модели по качеству кода пока уступают западным аналогам. На бойлерплейте разница незаметна, на сложной архитектуре АБС ощущается в полной мере. Важная оговорка: часть «российских» ассистентов — обёртки с BYOK (Bring Your Own Key), под капотом которых работают те же Claude, Gemini или Qwen. Суверенным там оказывается контур и биллинг, а не «мозги».
Третий — китайский open-source в своём контуре. DeepSeek и Qwen Coder пишут код уверенно, разворачиваются локально и не отправляют ничего наружу. Расплата: веса из Китая, а про предвзятость моделей мы только что говорили. Плюс нужны свои GPU-мощности и инженеры MLOps, которые умеют это обслуживать.
Четвёртый выход — гибрид. Российская среда или обёртка с маскировкой секретов до отправки в облако (так устроен, например, KodikShield), разные движки под разные задачи, единые ворота безопасности на выходе. Это самый прагматичный вариант. Его создатели признают, что полного суверенитета сегодня нет ни у кого, и переносят управление риском с выбора «правильной модели» на процесс, который одинаково недоверчиво проверяет любой сгенерированный код.
Так кто же виноват?
Когда уязвимость из вайб-кода доезжает до прода и превращается в инцидент, ответственность распределяется так же, как всегда, только артефактов стало больше, а ясности меньше.
Модель ни за что не отвечает. Она не субъект права и не подрядчик. Лицензионное соглашение любого ассистента прямо перекладывает ответственность на пользователя. Случай Replit показателен: за ошибку ответила платформа — репутацией и инжинирингом, а клиенту просто вернули деньги. Только вот утраченные данные его клиентов деньгами не вернёшь.
Разработчик несёт ответственность как автор промпта и как принявший код. Промпт — это техническое задание, коммит — подпись о приёмке. Рабочая метафора для внутренних регламентов: ИИ-код следует считать кодом талантливого стажёра с улицы. Он быстрый, начитанный, но не владеет предметной областью, не понимает регуляторных ограничений по типу банковской тайны, зато имеет привычку уверенно фантазировать. Такому стажёру нельзя давать разрешение править платёжный модуль без ревью старшего коллеги.
Компания отвечает как оператор. Регулятору и суду безразлично, кто нажимал на клавиши: утечка персональных данных или сбой критической информационной инфраструктуры (КИИ) — это вопрос к юрлицу и его процессам. Комплаенс-директор и правление отвечают за отсутствие периметра. Банк России оценивает не строчки кода, а систему управления операционным риском. Если в кредитной организации нет утверждённой матрицы допуска ИИ-инструментов, аудит признает процессы безопасной разработки несостоятельными. Это прямой путь к понижению рейтинга надёжности, увеличению резервов под операционные риски и персональной ответственности менеджмента вплоть до уголовной (ст. 293 УК РФ «Халатность») в случае сбоя систем, влияющих на стабильность финансового сектора.
Если формальной политики применения ИИ нет, компания фактически отдала управление риском на откуп каждому разработчику по отдельности. Это цитата-диагноз из разбора ЕМДЕВ, и с ней трудно спорить.
Как выстроить процесс: восемь практик вместо сухого чек-листа
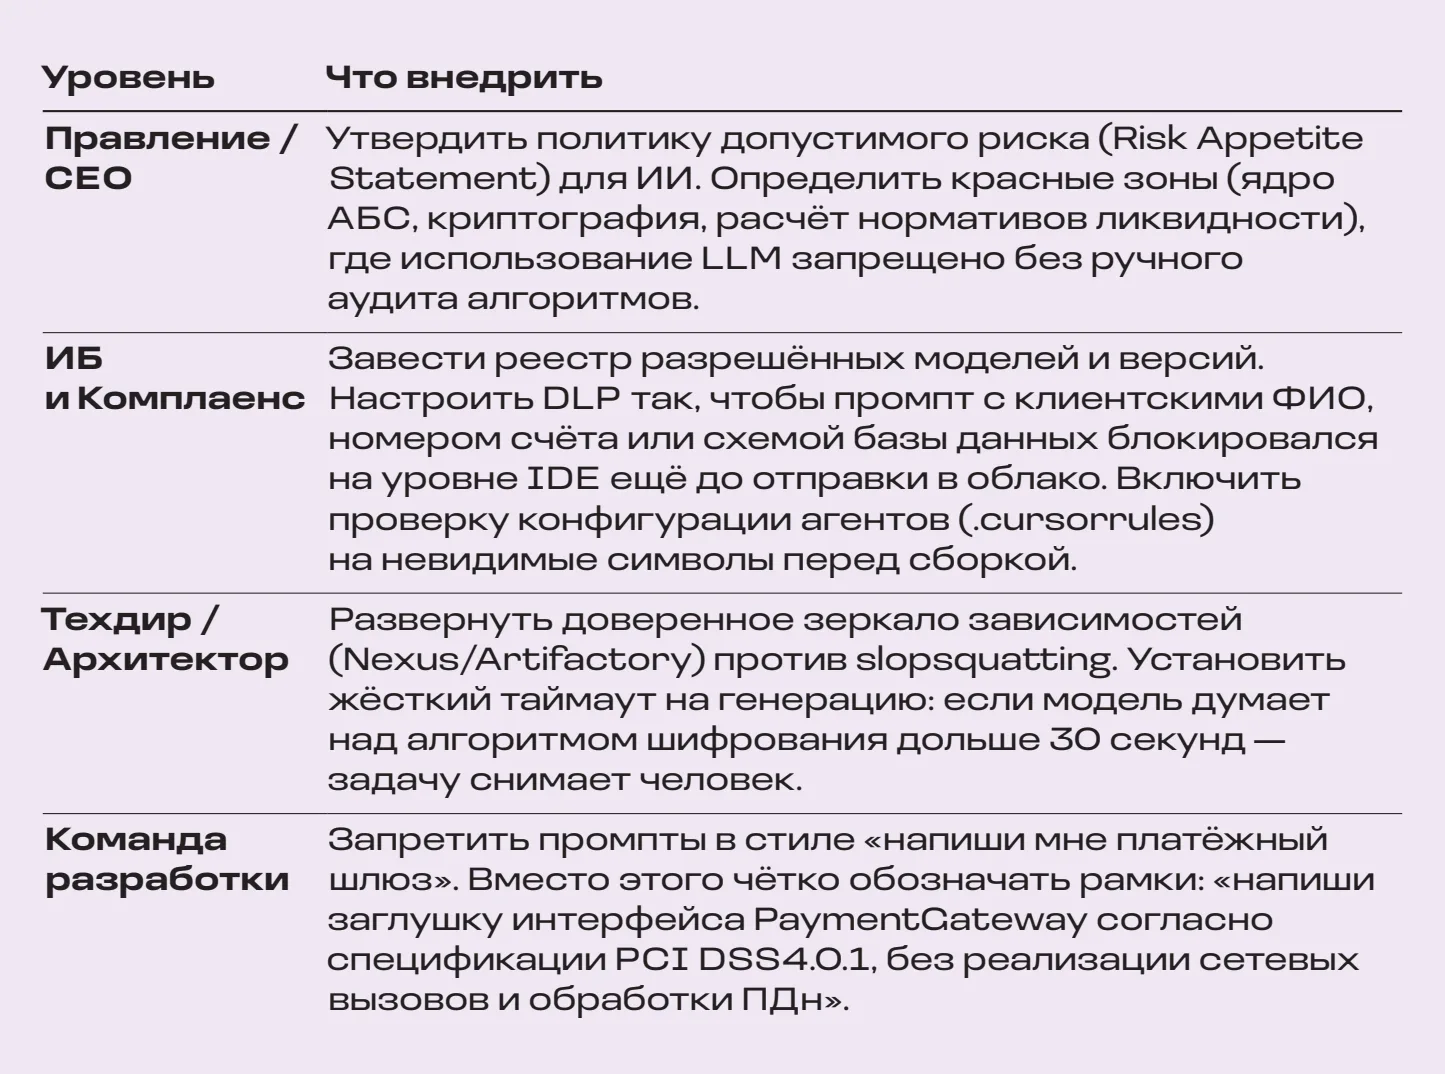
Ниже — рабочий каркас, собранный из рекомендаций «Лаборатории Касперского», практики ЕМДЕВ и здравого смысла. Он переводит язык методичек ИБ на язык управленческих решений.
От таблицы — к делу: восемь практик по шагам
Таблица выше раздала ответственность по уровням. Ниже — те же восемь практик, но в порядке внедрения: от документа, который разрешает работу, до метрики, которая покажет, работает ли всё это.
Политика допуска. Документ, который чётко определяет, какие инструменты разрешены, для каких задач, что в промптах запрещено (продовые данные, секреты, схемы КИИ), кто утверждает исключения. Даже список на одну страницу — бесконечно лучше, чем ничего.
Матрица критичности. Вайб-кодингу — зелёный свет для прототипов, внутренних скриптов ETL, нагрузочных тестов. Жёлтый — для бизнес-логики фронтэнда с обязательным двойным ревью. Красный — для аутентификации, платёжного ядра, криптографии, обработки персональных данных. В красной зоне работает только человек, это прямым текстом рекомендует и «Лаборатория Касперского».
Ревью ИИ-кода как чужого недоверенного. Любой ИИ-код проходит ревью компетентным разработчиком по отдельному чек-листу, учитывающему специфику: фантомные зависимости, секреты в коде, дефолтные конфиги, «красивые, но мёртвые» проверки прав доступа, обработку ошибок. Дежурная претензия «ревьюить некогда, темп не тот» решается матрицей из пункта 2: не весь код одинаково опасен.
Ворота в CI/CD. SAST, сканирование секретов и проверка версий зависимостей — для всего кода без ярлыков «человеческий/машинный». Машина не обижается, а процесс получает фиксированную оценку. Сюда же относится сканирование конфигурационных файлов ассистентов на невидимые Unicode-символы перед каждой сборкой.
Доверенное зеркало зависимостей. Против slopsquatting работает архитектура: внутренний репозиторий проверенных пакетов (Nexus, Artifactory), установка только из него, верификация любого нового имени (существование в апстрим-реестре, дата создания, число загрузок, автор) до включения в зеркало. Фантом, которого нет в зеркале, в сборку не попадёт.
Клетка для агентов. Урок Replit должен быть записан в регламент: у агента — минимально необходимые привилегии, разделённые среды dev/prod, запрет на действия без подтверждения в проде, режим «только чат» для боевых систем и восстановление в один клик. Агент с доступом к shell и клиентским данным — всё равно что сотрудник с правами root и без трудового договора.
Промпт-гигиена. Строка в промпте «следуй стандартам и лучшим практикам безопасности» заметно повышает качество результата. Полезен и второй проход: попросить модель проверить собственный код на ошибки и проанализировать каждую зависимость. В исследовании по slopsquatting такие приёмы снижали долю фантомных пакетов с 15–25% до 2,4–9,3%. Обратите внимание на формулировку: снижали, а не обнуляли. ИИ-проверка ИИ-кода — второй взгляд, а не независимый аудит.
Обучение и метрики. Разработчики должны знать специфику ИИ-рисков так же, как знают OWASP Top 10, а ИБ — измерять: долю ИИ-кода в релизе, долю находок в нём на SAST, среднее время ревью машинного текста. Что не измеряется, тем нельзя управлять. А управлять придётся, потому что доля ИИ-кода растёт.
Проверьте себя
Откройте регламент вашего DevSecOps. Найдите там слово «нейросеть», «ассистент» или LLM. Если поиск возвращает ноль результатов, значит, ваши разработчики работают по правилам десятилетней давности, подвергая банк рискам сегодняшнего дня.
Теперь возьмите последний релиз любого внутреннего продукта и задайте команде три вопроса: какая доля кода написана с ассистентом, кто конкретно принял каждый такой фрагмент и где это записано. Если на третий вопрос ответа нет — поздравляю, у значительной части вашей кодовой базы автор «никто». А «никто», как мы помним по инциденту Джейсона Лемкина, в ответственный момент может взять и запаниковать.