


Определяем автора. Новейшие технологии против социальной инженерии
В BIS Journal №3(34)/2019 мы публиковали статью «Задачка по биометрии: кто написал txt?», посвящённую современным технологиям определения авторства текста. Сегодня предлагаем краткий обзор самых современных направлений использования этих технологий в насущных задачах ИБ.
В СОЦИАЛЬНЫХ СЕТЯХ
Одной из первых систем обнаружения скомпрометированных аккаунтов в социальных сетях стала система COMPA [1], предложенная в 2015 году. Она основана на простом наблюдении: пользователи социальных сетей со временем вырабатывают привычки, и эти привычки весьма стабильны. Типичный пользователь социальной сети, например, может утром проверить сообщения с телефона, а во время обеденного перерыва с настольного компьютера. Кроме того, его сетевое взаимодействие скорее всего ограничено умеренным количеством социальных сетевых контактов (друзей).
Когда аккаунт попадает под чужой контроль, поток его сообщений имеет аномалии по сравнению с типичным поведением пользователя. COMPA строит поведенческий профиль для учётных записей социальных сетей, основанный на анализе сообщений, отправленных аккаунтом в прошлом. Каждое новое сообщение сравнивается с поведенческим профилем аккаунта. Если сообщение значительно отклоняется от профиля поведения, COMPA помечает его как возможно скомпрометированное. Возможности использования особенностей авторского стиля для обнаружения скомпрометированных аккаунтов изучались в целом ряде работ (см. обзор [2]).
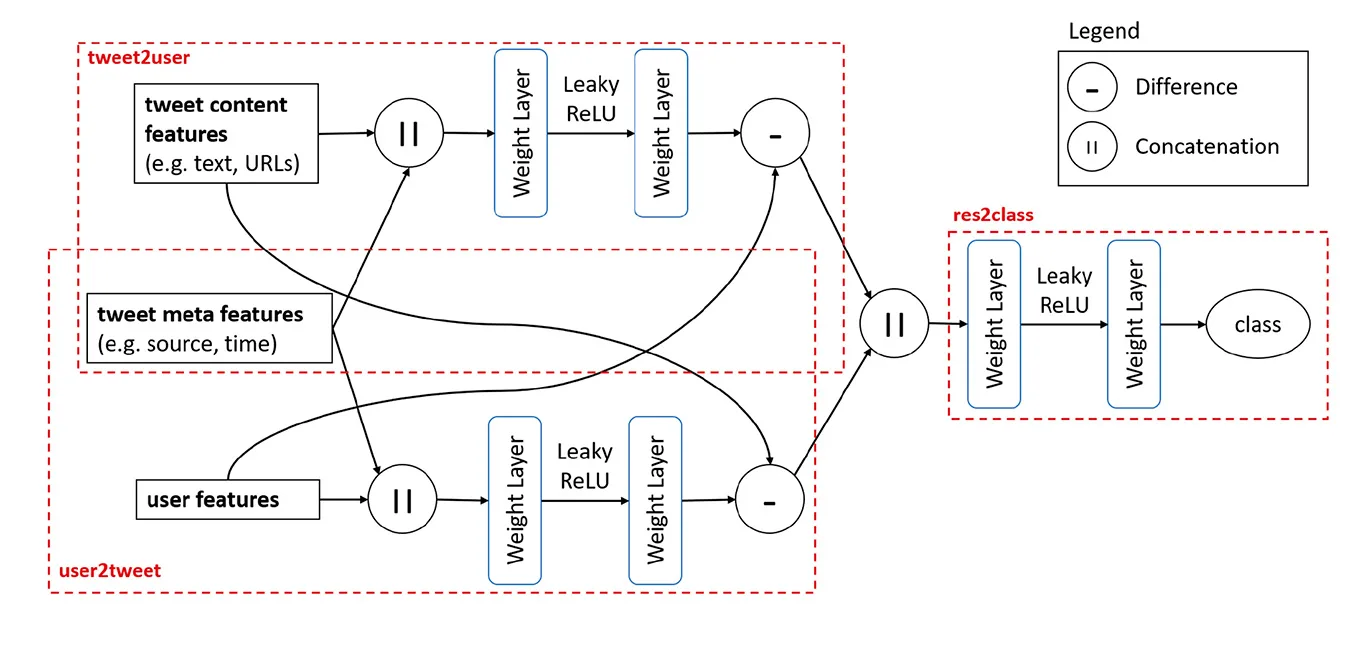
Специалистами из лаборатории Линкольна Массачусетского Технологического института и Мичиганского университета предложен [3] фреймворк CAUTE (Compromised Account User Tweet Encoder), который на основе предыдущих постов пользователя определяет, исходит новый пост от законного пользователя или его аккаунт уже скомпрометирован и захвачен кем-то другим. Фреймворк ориентирован на анализ материалов Твиттера. Используются глубокие нейронные сети, обучаемые на метаданных и текстах пользователя.
Качество этих и других разрабатываемых систем обнаружения скомпрометированных аккаунтов оценивается на тестовых базах сообщений. Изучаемыми характеристиками являются ошибки идентификации первого и второго родов (пропустить скомпрометированный аккаунт или принять истинный аккаунт за скомпрометированный) при следующих типовых параметрах тестовой базы: число аккаунтов около 2000, число твитов с каждого аккаунта – около 10.
БОРЬБА С ФИШИНГОМ
Фишинг с помощью электронной почты, при котором злоумышленник имитирует вызывающего доверие отправителя письма с помощью тщательно созданного сообщения и поддельных метаданных, предназначен для введения получателей почты в заблуждение. Его цель – обманом заставить жертв запустить вложение, содержащее вредоносный код, или открыть вредоносную ссылку. Такой подход иногда срабатывает даже в хорошо защищённых сетях.
Пользователям трудно отличить законные электронные письма от фишинговых без дополнительных защитных механизмов. Эти защитные механизмы, конечно, существуют, но могут быть неудобными для пользователей.
В ссылке [4] предложен автоматизированный подход к защите пользователей от фишинговых атак. Сначала строятся вероятностные модели как метаданных электронной почты, так и стилометрических характеристик содержимого электронной почты. Затем последующие электронные письма сравниваются с этими моделями, чтобы обнаружить характерные признаки фишинговых атак. Возможны разные варианты реализации такого подхода, включая выполнение обучения и оценки моделей исключительно на принимающей стороне или отправителей, публикующих модели, которые могут быть проверены получателем дистанционно. В работе приводятся оценки точности предложенного подхода, рассчитанные на реальных наборах данных 20 пользователей электронной почты (до десятков тысяч писем у каждого).
ПРОТИВ ФАЛЬШИВЫХ ОБЗОРОВ
В настоящее время высокую популярность имеют сайты с публикациями мнений пользователей товаров и услуг. Одной из основных проблем является проблема нечестных публикаций, когда человеку (например, маркетологу) платят за то, что он пишет благоприятные отзывы для одного продукта или плохие отзывы для конкурента. В ссылке [5] предложен метод выявления такого типа нечестных оценок. Метод основан на технологиях определения авторства текста. Существо метода состоит в вычислении наборов попарных метрик близостей авторского стиля в текстах обзоров. Вычисленные расстояния позволяют указать группы обзоров, которые близки друг к другу по авторскому стилю, и, следовательно, могут быть нечестными. На реальных материалах обзоров отелей (число авторов – 40) достигнута точность по F1-мере более 0,66. Предложенный подход может быть использован для анализа случаев возможного мошенничества с отзывами пользователей.
Литература
- Egele M., Stringhini G., Kruegel C., & Vigna G. (2017). Towards detecting compromised accounts on social networks. IEEE Transactions on Dependable and Secure Computing, vol. 14, no. 4, pp. 447–460.
- Barbon, S., Igawa, R., & Bogaz Zarpelão, B. (2017). Authorship verification applied to detection of compromised accounts on online social networks: A continuous approach. Multimedia Tools and Applications, 76(3), 3213–3233.
- VanDamС., Masrour F., Tan P., & Wilson T. (2019). You have been CAUTE! early detection of compromised accounts on social media. In Proceedings of the 2019 IEEE/ACM International Conference on Advances in Social Networks Analysis and Mining (ASONAM ’19). Association for Computing Machinery, NewYork, NY, USA, 25–32.
- Duman, S., Kalkan-Cakmakci, K., Egele, M., Robertson, W., &Kirda, E. (2016). Email Profiler: Spear phishing filtering with header and stylometric features of emails. In Proceedings of the 2016 IEEE 40th Annual Computer Software and Applications Conference. Vol. 1, pp. 408–416.
- Layton, R., Watters, P., &Ureche, O. (2013). Identifying faked hotel reviews using authorship analysis. In Proceedings - 4th Cybercrime and Trustworthy Computing Workshop, CTC ’13, pp.1–6.