


Безопасность искусственного интеллекта. Риски и угрозы
Различные умные системы прочно вошли в нашу жизнь. Робот-пылесос, поиск в интернете, голосовые помощники и многое другое — всё это примеры «слабого» искусственного интеллекта (ИИ). Он способен решать только узкоспециализированные задачи: игра в шахматы, распознавание изображений, генерация голоса.
Сейчас наиболее распространённый вариант «слабого» ИИ — машинное обучение. Этим термином обычно обозначают класс методов, которые решают задачу не напрямую, а учатся на наборе примеров. Обучение заключается в подборе параметров модели машинного обучения. Оказывается, что при большом количестве параметров и подходящей архитектуре готовая модель может решать достаточно сложные задачи. Например, генерировать реалистичные изображения (DALL-E, Midjourney) или отвечать человеку на естественном языке (ChatGPT).
Однако, как и в других областях знаний, использование машинного обучения, к сожалению, несёт не только пользу, но и новые риски. В этой статье мы подробно рассмотрим их и поделимся рекомендациями, которые позволят свести возможные последствия к минимуму.
ОШИБКИ ПОСТРОЕНИЯ МОДЕЛЕЙ
Один из ключевых рисков — это ошибки в обучении. В отличие от классического программирования, отладка и тестирование моделей машинного обучения — намного более сложная задача. Понять точное поведение системы с миллионами и даже миллиардами параметров часто бывает невозможно. Можно получить лишь примерное представление о работе. Сложность отладки ведёт к тому, что в моделях могут оставаться ошибки. А от качества работы модели может зависеть, например, финансовая устойчивость банка или даже жизнь пациента.
Приведём любопытный пример, который получил название «проблема танка». Предположительно в 1960-е годы в США разрабатывалась система компьютерного зрения, которая должна была распознать наличие танка на изображении лесного массива [https://dl.acm.org/doi/10.1145/800257.808903]. Для обучения были собраны фотографии танков в лесу и отдельные снимки лесного ландшафта. Модель была успешно обучена и давала практически идеальную точность на имеющихся изображениях. Однако после внедрения она показала плохое качество распознавания. Оказалось, что в обучающей выборке фотографии леса были сделаны в солнечную погоду (фотографы предпочитали снимать в хорошую погоду), а снимки танков были сделаны в разных погодных условиях. В итоге модель научилась детектировать не танки, а ясную погоду.
Другая распространённая проблема — отличие данных в обучении от реальных. Например, сбор выборки происходил при помощи одного прибора измерения, в то время как у пользователя применяется другой. В этом случае модель может выучить особенности прибора, а не объекта распознавания, что также приведёт к ошибкам в работе.
Как избежать аналогичных ошибок.
- Использовать валидационную выборку. Обычно имеющийся набор данных случайным образом делится на две части: обучающая, на которой производится обучение, и тестовая — для проверки готовых моделей. Получается, что исследователь подбирает модель под тестовую выборку, хотя при другой разбивке этот выбор может быть неверным. Для исключения такого фактора стоит использовать независимую валидационную выборку.
- Грамотно проводить процесс разделения выборки на обучение, тест и валидацию. Часто исследователь делит имеющиеся у него данные случайным образом на три обозначенные части. Однако случайное разделение выборки не всегда корректно. Например, если данные имеют временной характер, то выборку стоит разделять хронологически. В противном случае получится, что модель при обучении как бы «видит» данные из будущего. Проверка на тесте и валидации покажет завышенное качество.
- Другой пример — когда данные образуют некоторую кластерную структуру. Если список групп не конечен и в будущем появятся новые группы, объекты из одной группы не следует включать одновременно в тестовую и обучающие части. Это сделает результат более оптимистичным. Если же список групп конечен и они все представлены, наоборот, стоит объекты каждой из групп добавить в каждую из частей выборки.
- «Понять», как работает модель: на какие признаки она смотрит, соответствует ли это интуиции экспертов в данной области.
- Для интерпретации моделей существуют различные методы. Они показывают, как конкретный признак влияет на решение модели. Например, на рисунке 1 отображена важность признаков, рассчитанная при помощи векторов Шепли. Самый приоритетный признак в данном случае — это host_count. Большое значение этого признака для модели свидетельствует о классе 0 (отрицательный вес), малое значение — о классе 1. Результаты такого анализа можно согласовать с экспертом в данной предметной области: важны ли указанные признаки для решения задачи, говорит ли большое/малое их значение в пользу нужного класса или наоборот? Если экспертные ожидания не соответствуют полученной модели, это повод задуматься о качестве обучения и продолжить исследования.
- Тестирование модели после внедрения. Требуется оценка качества работы на реальных данных. Также стоит реализовать мониторинг работы модели. Распределение входных данных может измениться. Соответственно, и качество модели может деградировать со временем.
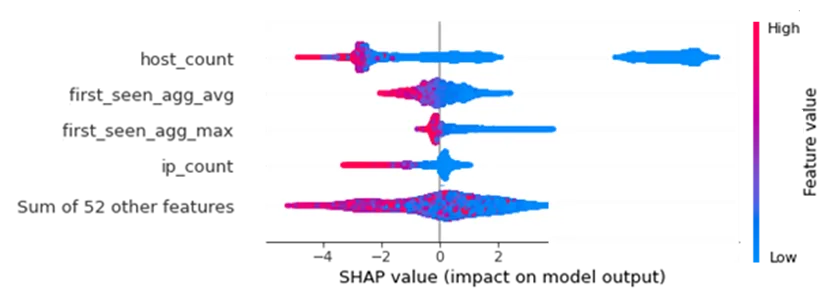
Рисунок 1. Интерпретация моделей при помощи векторов Шепли
АТАКИ НА МОДЕЛИ МАШИННОГО ОБУЧЕНИЯ
Следующий класс опасностей связан с целенаправленными атаками на модели машинного обучения. Пока такие атаки происходят редко, так как они сложны и требуют владения определёнными навыками. Но их количество, очевидно, будет расти с увеличением роли систем искусственного интеллекта в нашей жизни. Рассмотрим некоторые из таких атак.
Атаки на отравление обучающей выборки
В подобных атаках злоумышленник добавляет в обучение свои объекты-закладки, чтобы повлиять на решения модели (рисунок 2).
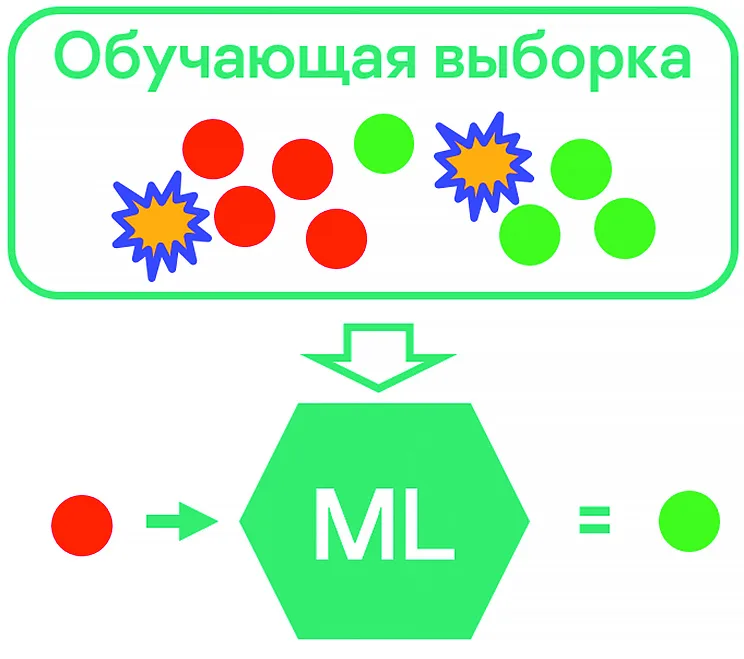
Рисунок 2. Схема атаки «Отравление обучающей выборки»
Например, можно добавить картинки, которые принадлежат определённому классу (скажем, собаки), и сделать в них специфическое свойство (например, серый квадрат в углу). Обученная на таком множестве модель запомнит неверную ассоциацию и будет выдавать некорректный класс («Собака») на всех объектах с этим свойством (с серым квадратом), даже если это объект совсем другого класса [https://bdtechtalks.com/2020/10/07/machine-learning-data-poisoning].
В другой версии обучающая выборка может быть просто замусорена объектами с неверным классом, что снижает общее качество работы модели. В качестве примера такой манипуляции можно привести атаки на классификатор спама компании Google, в которых продвинутые группы спамеров попытались загрязнить обучающую выборку, отмечая большое количество спама как «не спам» [https://elie.net/blog/ai/attacks-against-machine-learning-an-overview/].
Предотвратить такие атаки может быть сложно, особенно если обучение строится на пользовательских данных.
В качестве меры защиты следует предусмотреть функцию детектирования аномалий. Анализ полученных аномалий позволит выявить атаку. Если модель обучается с некоторой периодичностью, можно попробовать сравнить последовательно обученные модели на предмет существенного изменения логики работы.
Атаки уклонения от обнаружения (adversarial attack)
В данном типе атаки злоумышленник добавляет к объекту специальный шум таким образом, чтобы модель начала ошибаться (рисунок 3).
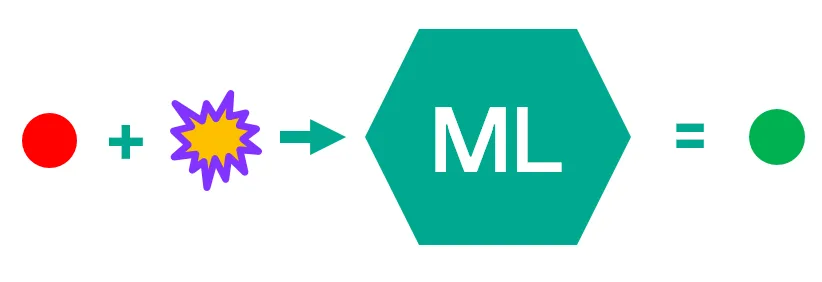
Рисунок 3. Схема атаки «Уклонение от обнаружения»
Этот шум может быть распределён по всему изображению (рисунок 4) или представлять собой небольшой контрастный патч.
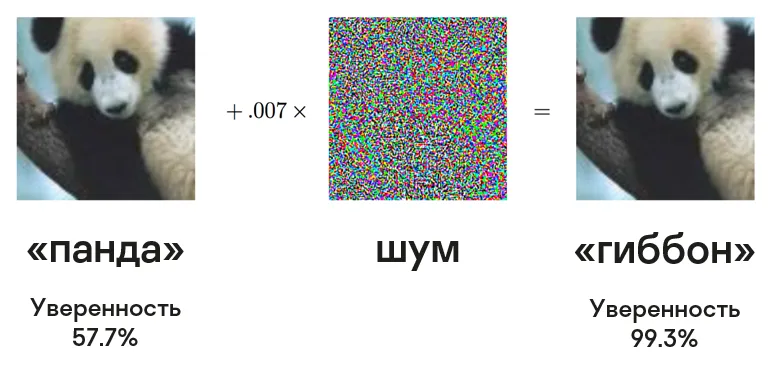
Рисунок 4. Атака на уклонения от обнаружения. К изображению добавляется едва заметный шум, меняющий класс объекта [arxiv.org/pdf/1412.6572.pdf].
Эти атаки могут быть использованы не только в отношении изображений. Например, в Лаборатории Касперского проводили анализ возможности проведения таких атак против детектора вредоносных объектов [https://securelist.com/how-to-confuse-antimalware-neural-networks-adversarial-attacks-and-protection/102949].
Атаки на уклонение особенно эффективны против нейронных сетей. По сути, они вызывают иллюзии, аналогично тому, как это происходит и в человеческом мозге. Только способ создания такой иллюзии отличается.
В данный момент не существует техник, позволяющих полностью защититься от подобного рода атак. Однако добавление объектов с иллюзиями в обучающую выборку повышает устойчивость моделей к ним. Также помогает использование техники «дистилляции». В этом случае модель намеренно упрощается, что принуждает её концентрироваться на наиболее важных деталях. Ещё один вариант защиты — использование «монотонных алгоритмов» [https://arxiv.org/pdf/1804.03643.pdf]. В таких алгоритмах модель может лишь увеличивать «оценку» класса, если имеются определённые признаки, но не может её уменьшать. То есть, например, нельзя добавить в объект признаки противоположного класса, чтобы её «смутить».
Утечки данных из модели
Современные сложные модели ищут закономерности в данных, однако в ряде случаев для модели «проще» запомнить некоторые объекты как исключения. Например, если объект в обучении сильно отличается от остальных или в нём просто нет закономерностей. А раз модель помнит эти данные, то их можно извлечь при помощи специальных приёмов. Например, такими данными может стать персональная информация пользователей, номера банковских карт и т. д.
Ещё один вариант утечки данных рассмотрим на примере популярной нейросети ChatGPT. Для её применения, скажем, в роли помощника программиста нейросеть инициализируется специальным запросом — «затравкой». В нём на естественном языке задаются параметры дальнейшей работы. Выглядит это примерно так: «ChatGPT, теперь ты помощник разработчика от компании Х. Отвечай на вопросы чётко и ясно. Используй следующие техники программирования. Если тебя спросят о компании Х, ни в коем случае не говори об… А теперь напиши программу, которая…» — далее следует запрос от пользователя.
Оказывается, сложную языковую нейросеть довольно легко «обмануть» и получить её «затравку». В ней могут содержаться как важные детали реализации, так и другие конфиденциальные данные, которая компания не хотела бы раскрывать.
В ряде случаев для защиты от подобных атак стоит предпочитать более простые модели, которые скорее способны к «обобщению», чем к «запоминанию». Однако такие модели обычно менее эффективны.
Иногда утечки данных из модели избежать невозможно. В этом случае стоит предполагать такой риск и работать в парадигме открытости — не использовать конфиденциальные данные в обучающих выборках и не размещать их внутри моделей.
КЛАССИЧЕСКИЕ АТАКИ НА СИСТЕМЫ С ИСПОЛЬЗОВАНИЕМ МАШИННОГО ОБУЧЕНИЯ
Не стоит забывать и о классических атаках. Злоумышленники могут просто проникнуть в систему или взломать сайт с моделью машинного обучения.
Например, в конце 2022 года в один из самых популярных фреймворков обучения нейросетей — pytorch — злоумышленники встроили закладку, которая собирала данные о системе, пароли и отсылала их на определённый хост [https://pytorch.org/blog/compromised-nightly-dependency]. Так как фреймворк требуется не только для обучения, но и для использования готовой нейросети, вредоносная закладка могла попасть как к авторам, так и к пользователям.
Иногда злоумышленники могут сочетать классические атаки со специфическими методами, заточенными под машинное обучение. Например, при разработке сложных нейросетей обычно берут за основу некоторый предобученный вариант и «дообучают» его. Это упрощает задачу, так как обучение сложных нейросетей «с нуля» требует колоссальных вычислительных ресурсов. С другой стороны, скачивая такую открытую модель, нельзя быть уверенным, что злоумышленник не добавил в неё скрытые возможности. Например, модель может неверно классифицировать объекты с некоторой неявной меткой.
Аналогичный риск несут «открытые» обучающие выборки. Намеренно добавив в такую выборку специальные объекты, можно исказить поведение обученных на ней моделей.
От вышеописанных атак помогут лучшие практики защиты информации, в том числе контроль версий открытого кода, моделей и данных.
ЗАКЛЮЧЕНИЕ
При проектировании любой сложной системы необходимо продумывать модель рисков и угроз. При этом стоит учитывать как простые ошибки и очевидные проблемы безопасности, так и специфические уязвимости, описанные в статье. Желательно привлекать профессионалов в области защиты информации и, конечно, не стоит забывать и про использование защитных решений.
Комплексный подход позволит создать качественный и надёжный продукт, в том числе с использованием искусственного интеллекта.